Dokładność tłumaczeń AI: właściwie zdiagnozuj problem i go rozwiąż
To samo narzędzie do tłumaczenia ekranu wczoraj działało dobrze, a dziś nagle pełne błędów; albo u znajomego jest celne, a w twoich rękach się sypie — większość ludzi w takiej sytuacji stwierdza najpierw „to narzędzie tłumaczy niedokładnie". To wniosek zbyt pochopny. Błędy tłumaczenia mają dwa zupełnie różne źródła: tekst nie został poprawnie odczytany albo został odczytany dobrze, ale źle przetłumaczony. Dopiero rozdzielenie tych dwóch spraw pozwala rozmawiać o problemie dokładności.
Najpierw rozdziel: błąd rozpoznawania i błąd tłumaczenia to dwie różne rzeczy
Tłumaczenie ekranu składa się z dwóch kroków: najpierw OCR zamienia tekst na ekranie na tekst edytowalny, a potem tłumaczenie AI przenosi ten tekst na wybrany przez ciebie język. Gdy którykolwiek krok zawiedzie, widzisz błędne tłumaczenie, ale odpowiedzialność i rozwiązania są zupełnie inne.
Sposób na rozróżnienie jest w samym kliencie: obok wyniku tłumaczenia znajduje się panel „rozpoznany oryginał", pokazujący, co OCR faktycznie odczytał tym razem. Jeśli sam panel rozpoznawania pełen jest błędów, problem leży w rozpoznawaniu — popraw obszar zaznaczenia i warunki ekranu; jeśli oryginał jest poprawny, a tłumaczenie nie, problem leży w tłumaczeniu — dostosuj model i terminologię. Zerknij najpierw w to miejsce, a kierunek diagnostyki nie zbłądzi.
Sześć typowych przyczyn błędów rozpoznawania OCR
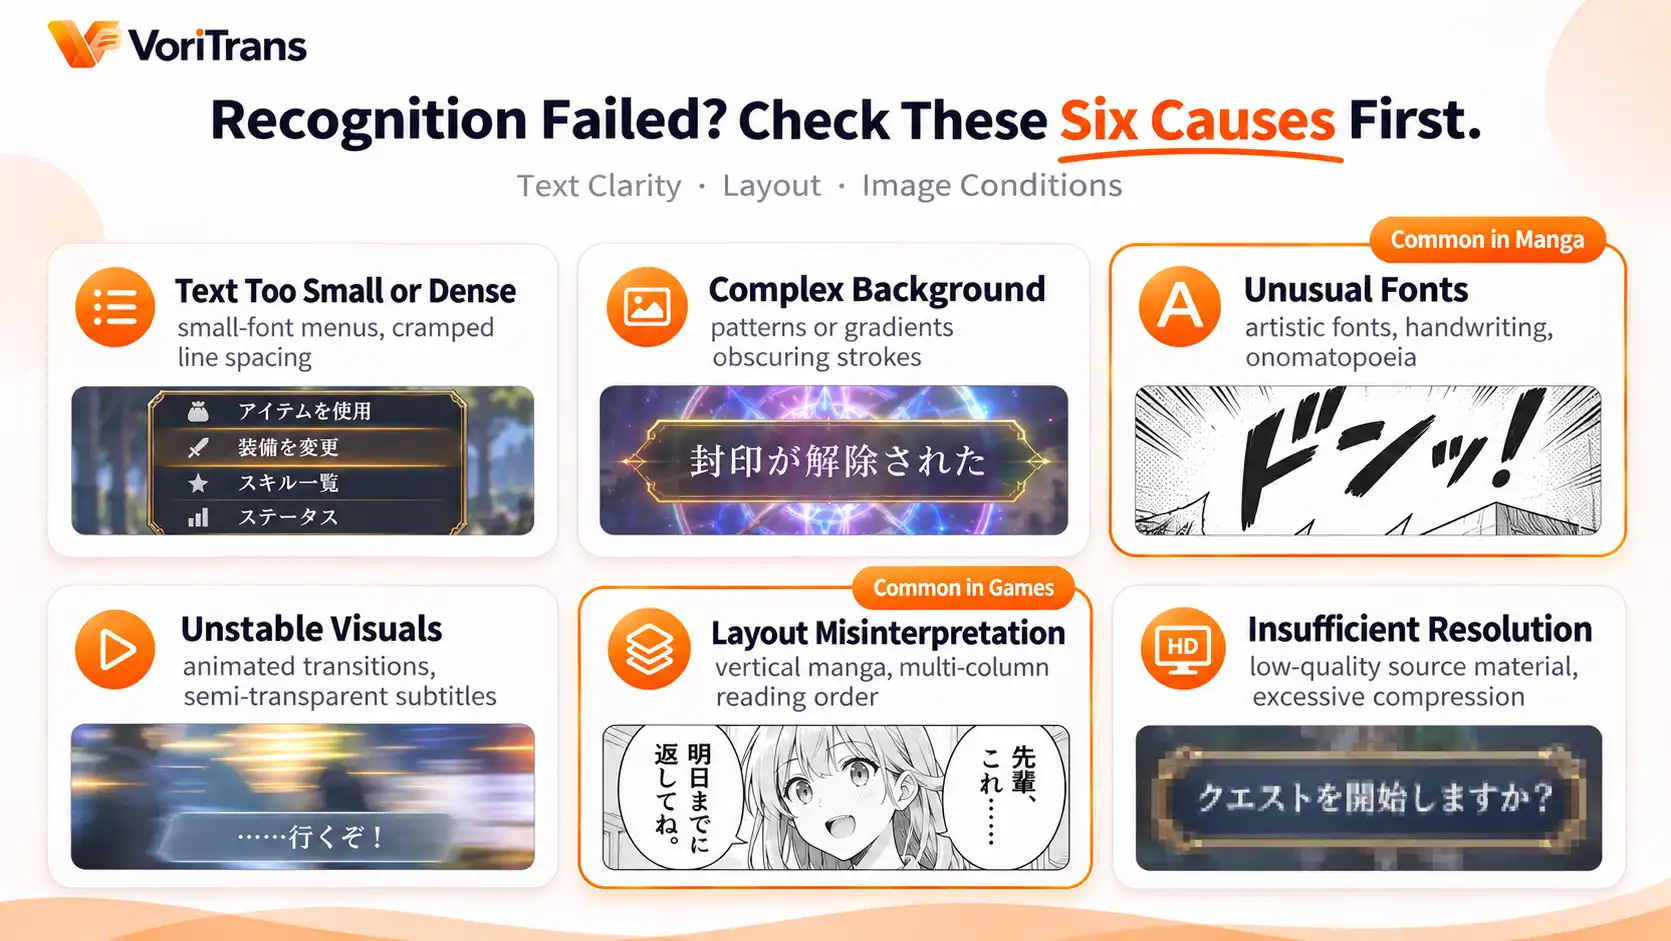
Jakość rozpoznawania zależy od czytelności tekstu, układu i warunków ekranu — według tej miary niemal wszystkie scenariusze awarii mieszczą się w sześciu kategoriach poniżej:
- Tekst zbyt mały lub zbyt gęsty: Drobne czcionki interfejsu gier, listy menu o ciasnej interlinii; znaki sklejają się, a OCR nie rozróżnia granic.
- Złożone tło: Tekst leży na wzorach, gradientach, efektach światła i cienia; kreski zlewają się z tłem.
- Nietypowa czcionka: Fonty ozdobne, pismo odręczne, zdeformowane onomatopeje; budowa znaków daleka od drukowanych.
- Niestabilny obraz: W momencie rozpoznawania obraz jest w ruchu — animacje przejściowe, napisy płynnie pojawiające się i znikające; odczytywane są półprzezroczyste lub niekompletne znaki.
- Błędna ocena układu: W mandze pionowej czy łamie wielokolumnowym błędne określenie kolejności czytania całkowicie miesza kolejność rozpoznanych zdań.
- Niewystarczająca rozdzielczość: Niskiej jakości źródło wideo, nadmiernie skompresowane zrzuty ekranu, rozmycie spowodowane skalowaniem systemu; skoro liter nie widzisz wyraźnie, narzędzie naturalnie też nie odczyta ich poprawnie.
Odpowiadające im rozwiązania: cztery kroki
Znając przyczynę, rozwiązanie leży wprost naprzeciwko niej. Na przykładzie VoriTrans diagnostykę możesz prowadzić w tej kolejności:
Krok 1: zawęź obszar zaznaczenia. Zaznacz tylko mały fragment z docelowym tekstem, nie obejmuj całego ekranu — im mniejsze zaznaczenie, tym mniej zakłóceń i dokładniejsze rozpoznawanie.
Krok 2: poczekaj, aż obraz się ustabilizuje, i dopiero tłumacz. W ustawieniach jest „czas oczekiwania na stabilizację obrazu" regulowany w milisekundach; przy treściach pełnych animowanych napisów i efektów przejścia pozwól narzędziu poczekać, aż obraz się ustatkuje, i dopiero wtedy rozpoznawać.

Krok 3: wypróbuj inny silnik OCR. Ustawienia oferują do wyboru 4 silniki OCR; przetestuj ten sam obraz innym silnikiem — wynik może wyraźnie się różnić; żaden silnik nie jest najlepszy w każdym scenariuszu, więc ustal ten, który dla twoich treści jest najstabilniejszy.
Krok 4: pojedyncza ponowna próba i korekta terminów. Jeśli pojedyncze fragmenty rozpoznają się źle, użyj „tłumaczenia jednorazowego" i zaznacz mały obszar ponownie; a stałe słowa, które ciągle są źle odczytywane (imiona, terminy systemowe), zapisz w „słowniku terminów" za pomocą funkcji korekty OCR jako poprawną pisownię — przy następnym tłumaczeniu zadziała to automatycznie.
Gdy tłumaczenie jest niedokładne: model, terminologia i właściwe oczekiwania
Jeśli rozpoznany oryginał jest poprawny, problem leży na etapie tłumaczenia, a tu także sporo do skonfigurowania. W modelu tłumaczenia zacznij od „modelu lokalnego" — nie zużywa kredytów, możliwości ma ograniczone, ale nadaje się do weryfikacji; w ważnych rozdziałach, gdzie wymagane jest rozumienie kontekstu, przełącz się na modele chmurowe (Qwen, DeepSeek, GLM) i porównaj tłumaczenie tego samego zdania — różnicę zwykle widać od razu, a zasady zużycia kredytów znajdziesz na oficjalnej stronie cennika.
Problemy tonu i imion rozwiązują dwie rzeczy: „prompt tłumaczenia gier" w ustawieniach pozwala dostosować styl tłumaczenia do klimatu utworu; słownik terminów przypisuje imiona głównych bohaterów i własne terminy do jednego ustalonego tłumaczenia, dzięki czemu utwór pozostaje spójny od początku do końca. Ustaw też właściwe oczekiwania: celem tłumaczenia AI jest to, byś płynnie czytał rozwój fabuły w swoim języku, a nie wydawnicza, literacka dokładność — interpretowanie pojedynczych zdań z pomocą kontekstu i obrazu to normalny sposób korzystania, a nie awaria narzędzia. Więcej tła o błędach rozpoznawania znajdziesz w naszym poprzednim artykule czym jest tłumacz ekranu.
Kiedy podejrzewać sam obraz
Po pełnej diagnostyce istnieje klasa problemów, których źródło nie leży w narzędziu: niskiej jakości źródła wideo, zamazane lub cenzurowane kadry, zaszyfrowane treści, ekskluzywny tryb pełnoekranowy — sam obraz nie dostarcza tekstu do rozpoznania i każde narzędzie pokaże to samo. Gdy rozpoznawanie w trybie pełnoekranowym szwankuje, najpierw przełącz się na tryb okna lub bezramkowy i spróbuj ponownie — to oficjalna podstawowa rekomendacja. I odwrotnie: aby sprawdzić prawdziwy poziom narzędzia, testuj je na czytelnym, stabilnym obrazie: darmowe kredyty, które zużywa model lokalny, to 1,000 miesięcznie dla gości i 2,000 po rejestracji; przetestuj przez jeden wieczór na treściach, które regularnie oglądasz — to pewniejsze niż jakakolwiek recenzja.
Częste pytania
Jak dokładne może być tłumaczenie AI?
Nie ma jednej liczby i nie powinno jej być — dokładność zależy od czytelności tekstu, układu i warunków ekranu; ta sama treść daje inny wynik przy innym sposobie wyświetlania. Odpowiedzialne narzędzie nie obiecuje procentów; może otworzyć ci panel „rozpoznany oryginał" do samodzielnej weryfikacji: najpierw sprawdź, czy rozpoznano poprawnie, a potem patrz na tłumaczenie — od razu widać, w którym ogniwie jest problem.
Co zrobić, gdy te same słowa są ciągle źle rozpoznawane?
Skorzystaj z korekty OCR w słowniku terminów: dodaj oryginalne słowo odczytywane błędnie wraz z poprawną pisownią; w razie potrzeby włącz ignorowanie wielkości liter w języku angielskim. Zmiana zadziała automatycznie przy następnym tłumaczeniu, bez ręcznej poprawki za każdym razem. Słownik obsługuje import i eksport, więc zabierzesz go przy zmianie urządzenia.
Czy przejście na model chmurowy tłumaczy dokładniej?
Zwykle lepiej radzi sobie ze zrozumieniem kontekstu i długimi zdaniami, a kosztem jest zużycie kredytów. Porównaj na tym samym zdaniu dialogu: jedno tłumaczenie modelem lokalnym, jedno — chmurowym; jeśli różnica pasuje do twoich treści, wybierz ją — krótkie dialogi tłumaczyć modelem lokalnym za darmo, a w ważnych rozdziałach przechodzić na chmurowy to typowy balans kosztów i jakości.