Genauigkeit der KI-Bildschirmübersetzung: Fehler verstehen und beheben
Dasselbe Übersetzungstool für den Bildschirm: gestern lief alles prima, heute ist die Ausgabe plötzlich voller Fehler; oder bei einem Freund funktioniert es präzise und in Ihren Händen gerät alles durcheinander — die erste Reaktion der meisten Menschen ist dann: „Das Tool übersetzt ungenau." Dieses Urteil fällt zu schnell. Falsche Ausgaben haben zwei völlig verschiedene Ursachen: Der Text wurde nicht korrekt erkannt, oder er wurde korrekt erkannt, aber schlecht übersetzt. Erst wenn man diese beiden Fälle trennt, lässt sich sinnvoll über Genauigkeit sprechen.
Erst trennen: Erkennungsfehler und Übersetzungsfehler sind zweierlei
Die Bildschirmübersetzung läuft in zwei Schritten: Zuerst wandelt die OCR den Text auf dem Bildschirm in editierbaren Text um, dann überträgt die KI-Übersetzung diesen Text in Ihre gewünschte Sprache. Scheitert einer der beiden Schritte, ist das Ergebnis falsch — doch Verantwortung und Lösung unterscheiden sich komplett.
Das Unterscheidungsmittel steckt im Client: Neben dem Übersetzungsergebnis zeigt ein Panel „Erkannter Text", was die OCR diesmal tatsächlich gelesen hat. Ist dieses Panel bereits voller Fehler, ist es ein Erkennungsproblem — justieren Sie den Auswahlrahmen und die Bildbedingungen. Ist der erkannte Text korrekt und nur die Übersetzung falsch, ist es ein Übersetzungsproblem — justieren Sie Modell und Terminologie. Wer vor dem Handeln diesen einen Blick zur Gewohnheit macht, verliert bei der Fehlersuche nie die Richtung.
Sechs häufige Ursachen für OCR-Erkennungsfehler
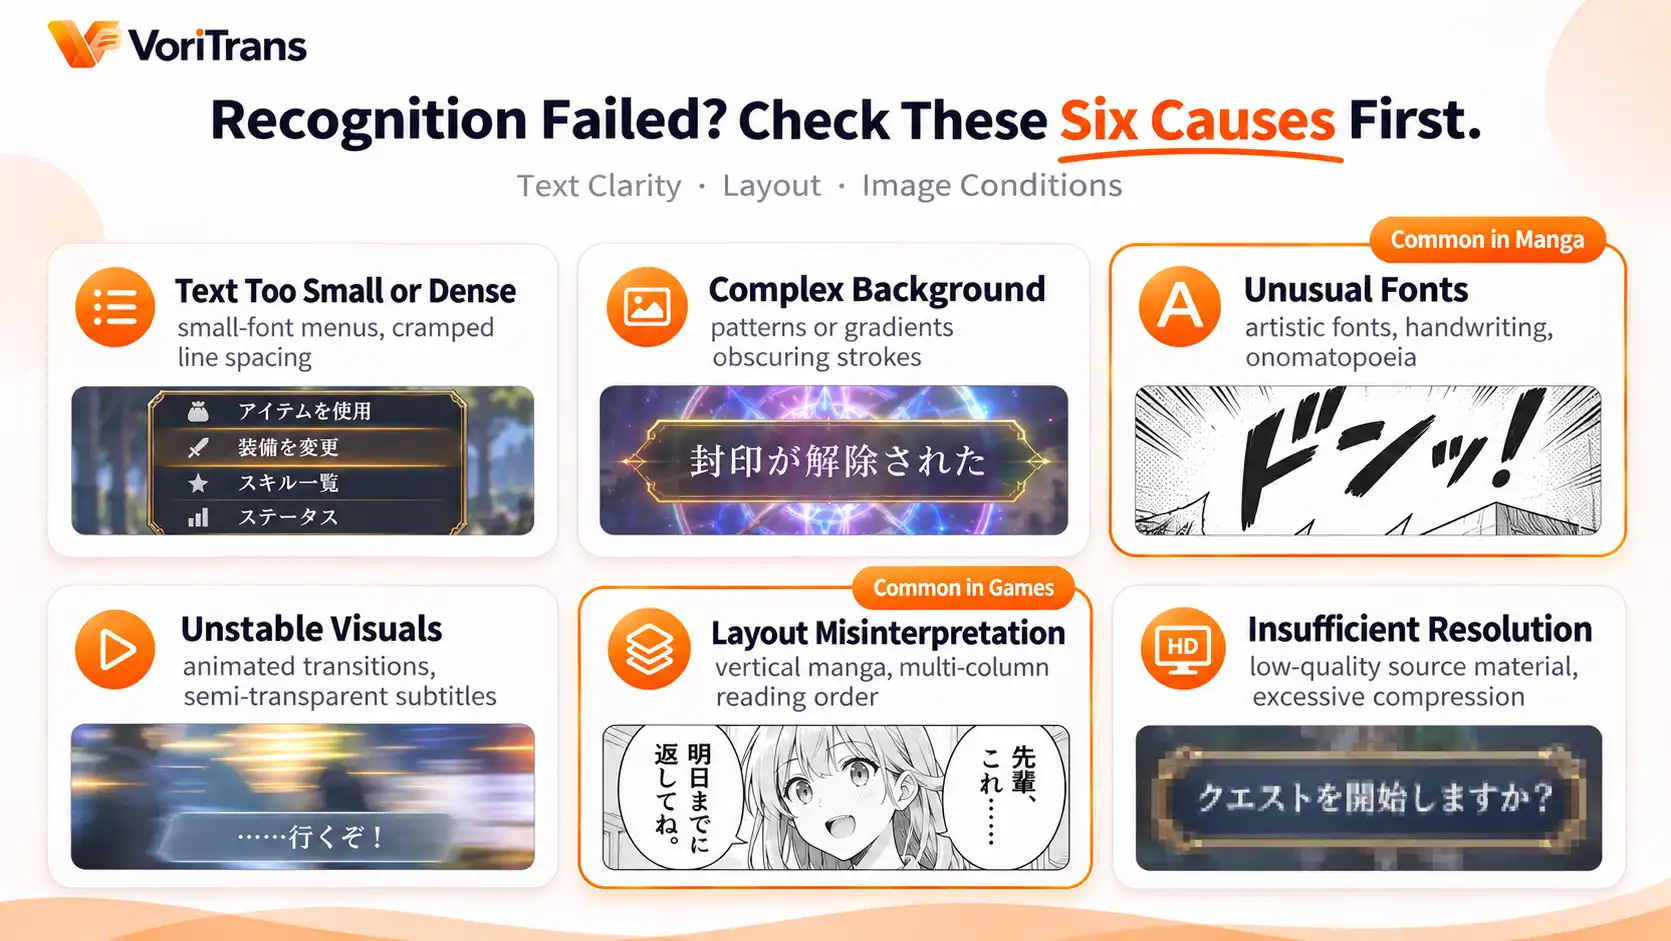
Die Erkennungsqualität hängt von Textschärfe, Layout und Bildbedingungen ab — an dieser Latte gemessen, lassen sich Fehlerfälle im Wesentlichen in die folgenden sechs Kategorien einordnen:
- Text zu klein oder zu dicht: Kleinschrift in Spiele-Oberflächen, Menülisten mit engem Zeilenabstand — die Zeichen verschmelzen, die OCR erkennt keine Grenzen.
- Komplexer Hintergrund: Der Text liegt über Mustern, Verläufen oder Lichteffekten, die Striche verschwimmen mit dem Hintergrund.
- Besondere Schriftarten: Zierschriften, Handschrift, verzerrte Lautnachahmungen — die Strukturen der Striche sind weit von Druckschrift entfernt.
- Instabiles Bild: Im Moment der Erfassung bewegt sich das Bild — Zwischensequenzen, ein- und ausblendende Untertitel — und das Tool liest halbtransparente oder unvollständige Zeichen.
- Falsche Layout-Erkennung: Bei vertikalen Mangas oder mehrspaltigen Layouts gerät die Reihenfolge der erkannten Sätze völlig durcheinander, sobald die Leserichtung falsch eingeschätzt wird.
- Unzureichende Auflösung: Quellen in niedriger Qualität, überkomprimierte Screenshots, Unschärfe durch Systemskalierung — wenn Sie den Text selbst kaum lesen können, kann das Tool es erst recht nicht.
Passende Fehlerbehebung in vier Schritten
Kennt man die Ursache, heißt die Lösung: gezielt nachjustieren. Am Beispiel von VoriTrans gehen Sie so vor:
Schritt 1: Auswahlbereich verkleinern. Erfassen Sie nur den kleinen Bereich mit dem Zieltext, nicht den ganzen Bildschirm — je kleiner die Auswahl, desto weniger Störungen und desto genauer die Erkennung.
Schritt 2: Auf ein stabiles Bild warten, dann übersetzen. In den Einstellungen lässt sich die „Bildstabilitätswartezeit" millisekundengenau anpassen; bei Inhalten mit animierten Untertiteln oder vielen Übergangseffekten lassen Sie das Tool warten, bis das Bild zur Ruhe kommt, bevor es erkennt.

Schritt 3: Eine andere OCR-Engine wählen. In den Einstellungen stehen 4 OCR-Engines zur Auswahl; auf demselben Bild kann ein anderer Motor das Ergebnis deutlich verändern — keine Engine führt in jeder Situation, fixieren Sie also diejenige, die auf Ihren Inhalten am zuverlässigsten arbeitet.
Schritt 4: Einmalige Wiederholung plus Begriffskorrektur. Wird ein einzelner Bereich schlecht erkannt, nehmen Sie ihn mit der „Einzelübersetzung" noch einmal enger auf; feste Begriffe, die ständig falsch gelesen werden (Eigennamen, Systembegriffe), hinterlegen Sie im „Fachwörterbuch" per OCR-Korrektur mit der richtigen Schreibweise — ab der nächsten Übersetzung greift die Korrektur automatisch.
Was tun bei ungenauer Übersetzung: Modell, Terminologie und die richtigen Erwartungen
Ist der erkannte Text korrekt und liegt das Problem an der Übersetzung, gibt es noch zahlreiche Stellschrauben. Beginnen Sie beim Übersetzungsmodell mit dem „lokalen Modell": Es verbraucht keine Credits, seine Fähigkeiten sind begrenzt, zum Prüfen taugt es aber gut; bei wichtigen Passagen, die Kontextverständnis verlangen, wechseln Sie zu einem Cloud-Modell (Qwen, DeepSeek, GLM) und vergleichen die Übersetzung desselben Satzes — der Unterschied ist meist sofort sichtbar. Die Credit-Regeln der Cloud-Modelle finden Sie auf der offiziellen Preisseite.
Ton und Eigennamen überlassen Sie zwei Funktionen: Der „Spiele-Übersetzungsprompt" in den Einstellungen passt den Übersetzungsstil an, damit die Ausgabe dem Ton des Werks entspricht; im Fachwörterbuch legen Sie Figurennamen und eigens geprägte Begriffe auf eine einheitliche Übersetzung fest, sodass das ganze Werk konsistent bleibt. Justieren Sie auch Ihre Erwartungen: Ziel der KI-Übersetzung ist, dass Sie der Handlung flüssig folgen können — nicht eine verlagsreife Feinübersetzung. Einzelne Sätze mit Kontext und Bild zu erschließen, gehört zum normalen Umgang und ist kein Tool-Defekt. Mehr Hintergrund zur Erkennung finden Sie im früheren Beitrag Was ist ein Bildschirmübersetzer.
Wann der Bildschirm selbst schuld ist
Am Ende der Fehlersuche bleibt eine Kategorie von Problemen übrig, bei denen das Tool unschuldig ist: Quellen in niedriger Qualität, zensierte oder verpixelte Bilder, verschlüsselte Inhalte, exklusiver Vollbildmodus — das Bild selbst liefert keinen lesbaren Text, und kein Tool ändert daran etwas. Wenn die Erkennung im Vollbild verrücktspielt, wechseln Sie zuerst in den Fenstermodus oder den rahmenlosen Modus und versuchen es erneut — das ist der offizielle Standardrat für diesen Fall. Umgekehrt gilt: Um das wahre Können eines Tools zu prüfen, testen Sie es mit klaren, stabilen Bildinhalten. Die Gratis-Credits — 1,000 pro Monat für Gäste, 2,000 nach der Registrierung — reichen, um einen Abend lang Ihre üblichen Inhalte laufen zu lassen; das sagt mehr als jeder Testbericht.
Häufige Fragen
Wie genau kann KI-Übersetzung werden?
Eine einheitliche Zahl gibt es nicht, und es sollte auch keine geben — die Genauigkeit hängt von Textschärfe, Layout und Bildbedingungen ab, und derselbe Inhalt liefert bei anderer Darstellung andere Ergebnisse. Ein verantwortungsvolles Tool verspricht keine Prozentsätze. Es kann stattdessen das Panel „Erkannter Text" öffnen, damit Sie selbst prüfen: Erst die Erkennung kontrollieren, dann die Übersetzung — so sehen Sie auf einen Blick, an welchem Glied es hakt.
Immer dieselben Wörter werden falsch erkannt — was tun?
Nutzen Sie die OCR-Korrektur im Fachwörterbuch: Hinterlegen Sie das falsch gelesene Originalwort und die richtige Schreibweise; eine Option zum Ignorieren der englischen Groß-/Kleinschreibung ist verfügbar, und Änderungen greifen ab der nächsten Übersetzung automatisch — kein manuelles Nachbessern jedes Mal. Das Fachwörterbuch unterstützt Import und Export, Sie nehmen es also beim Gerätewechsel einfach mit.
Übersetzt ein Cloud-Modell genauer?
Kontextverständnis und die Verarbeitung langer Sätze sind meist besser, der Preis ist der Credit-Verbrauch. Vergleichen Sie an derselben Dialogzeile: einmal mit dem lokalen Modell, einmal mit dem Cloud-Modell — und nutzen Sie den, dessen Ergebnis zu Ihren Inhalten passt. Kurze Dialoge kostenlos mit dem lokalen Modell, wichtige Kapitel mit dem Cloud-Modell: das ist der übliche Kompromiss zwischen Kosten und Qualität.