
Nauwkeurigheid van AI-vertaling: hoe je problemen diagnoseert en oplost
Hetzelfde schermvertaalprogramma: gisteren werkte het uitstekend en vandaag staat het opeens vol fouten; of bij een vriend werkt het precies en als jij het probeert, komt er een geknoei uit. In zo'n situatie is de eerste reactie van de meeste mensen: „dit programma vertaalt niet nauwkeurig". Die conclusie komt te snel. Fouten in de vertaling hebben twee totaal verschillende oorsprongen: de tekst is niet juist gelezen, of hij is goed gelezen maar slecht vertaald. Pas als je deze twee dingen scheidt, is er iets zinnigs te zeggen over nauwkeurigheid.
Eerst scheiden: een herkenningsfout en een vertaalfout zijn twee verschillende dingen
Het proces van schermvertaling bestaat uit twee stappen: de OCR zet eerst de tekst op het scherm om in bewerkbare tekst, daarna vertaalt de AI die tekst naar de taal die jij kiest. Gaat er in een van beide stappen iets mis, dan klopt de vertaling die je ziet niet, maar de verantwoordelijkheid en de oplossing zijn totaal verschillend.
Het onderscheid zit in de client zelf: naast het vertaalresultaat staat een paneel „herkende brontekst" dat laat zien wat de OCR dit keer werkelijk gelezen heeft. Staat dat paneel al vol fouten, dan is het een herkenningsprobleem: pas het selectiekader en de beeldomstandigheden aan. Is de brontekst juist maar de vertaling niet, dan is het een vertaalprobleem: stel model en terminologie bij. Kijk eerst dit even na voordat je handelt, dan slaat het zoeken niet de verkeerde kant op.
Herkenningsfout van de OCR: de meestvoorkomende oorzaken zijn er zes
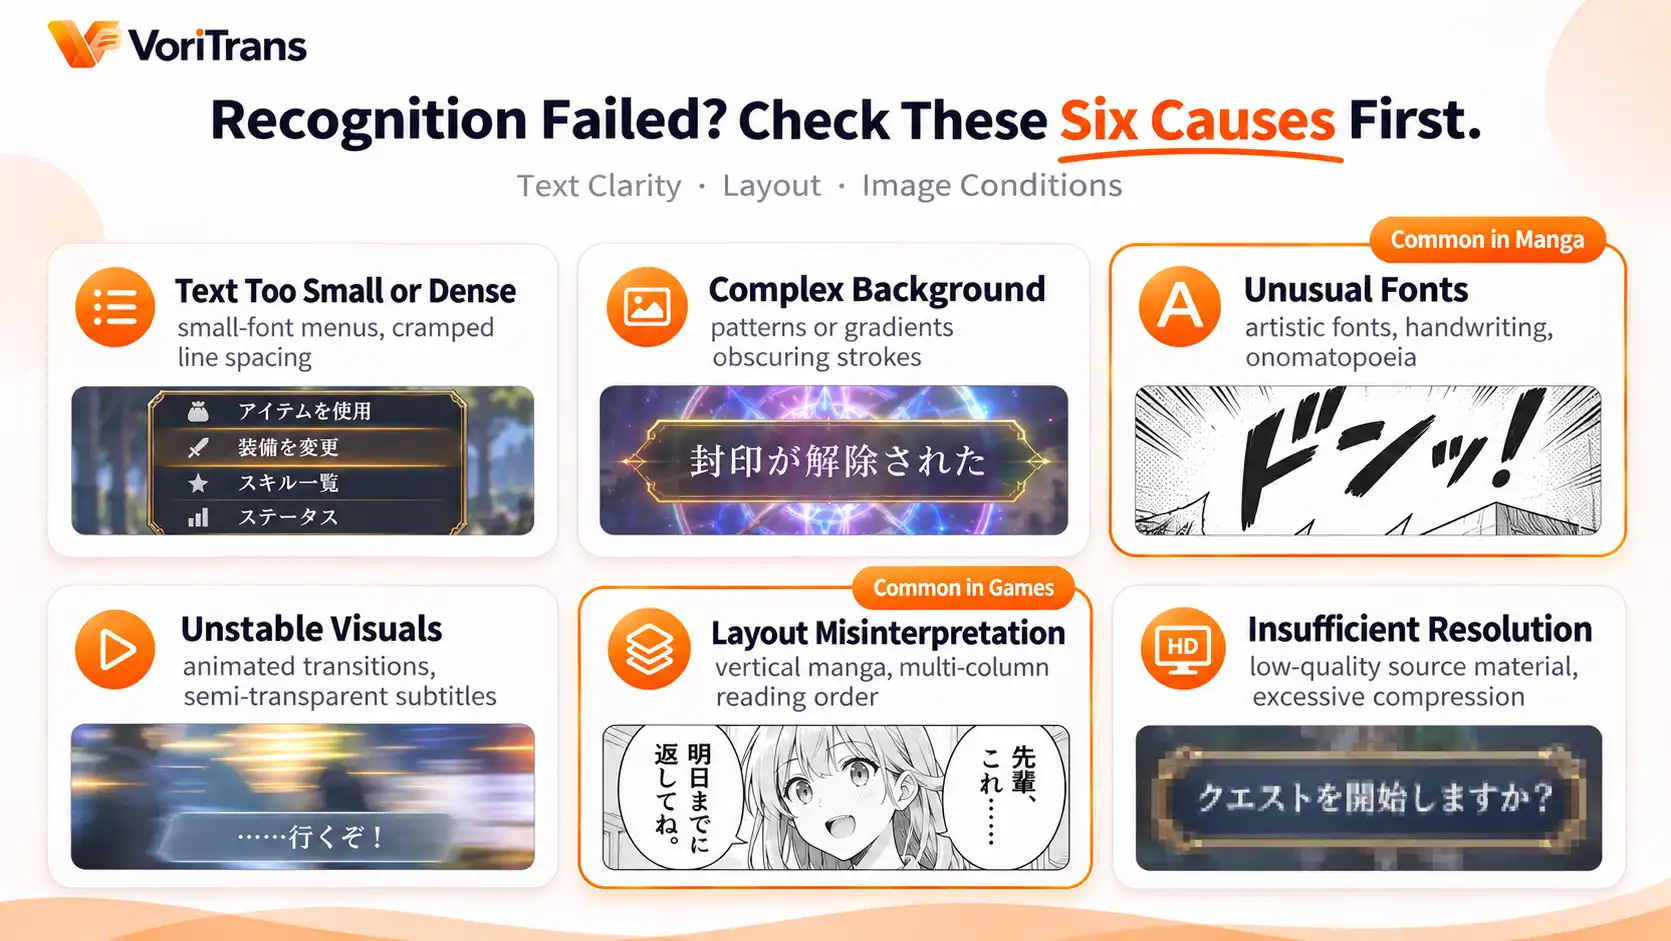
De herkenningskwaliteit hangt af van de scherpte van de tekst, de indeling en de beeldomstandigheden — langs deze meetlat passen vrijwel alle faalsituaties in zes categorieën:
- Tekst te klein of te dicht op elkaar: kleine letters in game-interfaces, menulijsten met een krappe regelafstand — de tekens plakken aan elkaar en de OCR ziet de grenzen niet.
- Complexe achtergrond: de tekst ligt over patronen, kleurverlopen en lichteffecten en de streken mengen zich met de achtergrond.
- Speciale lettertypen: sierletters, handschrift en vervormde onomatopeeën hebben een streekstructuur die ver afstaat van gedrukte lettertypen.
- Instabiel beeld: op het moment van herkenning beweegt het beeld — overgangsanimaties, in- en uitfazende ondertitels; er worden halfdoorzichtige of onvolledige tekens gelezen.
- Verkeerd ingeschatte indeling: bij verticale manga of lay-outs met meerdere kolommen gaat, zodra de leesvolgorde verkeerd bepaald wordt, de volgorde van de herkende zinnen helemaal los.
- Onvoldoende resolutie: video van lage kwaliteit, te sterk gecomprimeerde schermafbeeldingen, wazigheid door systeemschaling — als jij de letters al niet kunt lezen, kan het programma ze ook niet lezen.
Wat kun je doen: vier stappen
Ken je de oorzaak, dan is de oplossing gericht bijstellen. Met VoriTrans als voorbeeld kun je het zoeken in deze volgorde doen:
Stap 1: verklein het selectiekader. Kader alleen het stukje in waar de gewenste tekst staat, niet het hele scherm — hoe kleiner het kader, hoe minder storing en hoe nauwkeuriger de herkenning.
Stap 2: wacht tot het beeld stabiel is voor je laat vertalen. In de voorkeuren staat de optie „wachttijd voor beeldstabilisatie", instelbaar in milliseconden; bij content met geanimeerde ondertitels of veel overgangseffecten laat je het programma wachten tot het beeld tot rust is gekomen.

Stap 3: wissel van OCR-engine. De voorkeuren bieden 4 OCR-engines om uit te kiezen; probeer op hetzelfde beeld een andere engine — het resultaat kan duidelijk verschillen. Geen enkele engine wint in elk scenario: kies degene die bij jouw content het stabielst werkt en blijf daarbij.
Stap 4: eenmalige herkansing en termcorrectie. Zijn een aantal vakken slecht herkend, gebruik dan de „eenmalige vertaling" met een klein kader om dat stukje en probeer opnieuw; voor vaste woorden die altijd verkeerd gelezen worden (eigennamen, systeemtermen) zet je in de „termenbibliotheek" met OCR-correctie de juiste spelling van het originele woord vast — die werkt automatisch door bij de volgende vertaling.
Wat te doen bij onnauwkeurige vertaling: modellen, terminologie en juiste verwachtingen
Is de herkende brontekst juist en zit het probleem in de vertaling, dan is er ook genoeg af te stellen. Kies voor het vertaalmodel eerst het „lokale model", dat geen credits verbruikt: beperkt in kunnen, maar geschikt om te toetsen; voor belangrijke hoofdstukken waar contextbegrip telt, schakel je over op cloudmodellen (Qwen, DeepSeek, GLM) en vergelijk je de vertaling van dezelfde zin — het verschil is meestal direct zichtbaar. De regels voor creditverbruik vind je op de officiële prijspagina.
Toon en namen zijn twee dingen: met de „gamevertaalprompt" in de voorkeuren stel je de vertaalstijl af op de toon van het werk, en de termenbibliotheek fixeert namen van personages en eigen termen van de wereld in eenzelfde vertaling, consistent door het hele werk. Ook de verwachtingen moeten kloppen: het doel van AI-vertaling is dat je het verhaal vlot kunt volgen, geen vertaling op uitgeversniveau — een enkele zin met de context en het beeld erbij interpreteren hoort bij normaal gebruik en is geen storing. Meer achtergrond over herkenningsfouten vind je in het eerdere artikel wat is een schermvertaler.
Wanneer mag je het beeld zelf verdenken
Aan het einde van het zoeken is er een categorie problemen waarvan de oorzaak niet in het programma ligt: video van lage kwaliteit, beelden met mozaïekcensuur, beveiligde content en exclusieve volledig-schermmodus — het beeld zelf biedt geen herkenbare tekst en geen enkel programma kan daar iets aan doen. Loopt de herkenning in volledig scherm mis, schakel dan eerst naar venstermodus of randloze modus en probeer het opnieuw: dat is de gangbare officiële aanbeveling. Andersom geldt: om het echte niveau van een programma te toetsen, test je het met scherpe, stabiele beelden. Het lokale model verbruikt gratis credits — 1.000 per maand voor gasten en 2.000 na registratie —; laat het een avond draaien op de content die je normaal kijkt: dat zegt meer dan welke review dan ook.
Veelgestelde vragen
Hoe nauwkeurig kan AI-vertaling zijn?
Er is geen eenduidig getal, en dat hoeft ook niet — de nauwkeurigheid hangt af van de scherpte van de tekst, de indeling en de beeldomstandigheden, en dezelfde inhoud geeft bij een andere weergave andere resultaten. Een verantwoord programma belooft geen percentages; het kan wel het paneel „herkende brontekst" openstellen zodat je het zelf controleert. Klopt de herkenning, kijk dan pas naar de vertaling — dan zie je meteen in welke schakel het probleem zit.
Wat te doen als steeds dezelfde woorden verkeerd worden herkend?
Gebruik de OCR-correctie in de termenbibliotheek: voeg het verkeerd gelezen originele woord samen met de juiste spelling toe; je kunt de optie om hoofdlettergebruik te negeren aanvinken, en de wijziging werkt automatisch door bij de volgende vertaling, zonder elke keer handmatig te corrigeren. De bibliotheek ondersteunt importeren en exporteren, dus je neemt hem mee bij een wissel van apparaat.
Vertaalt een cloudmodel nauwkeuriger?
Begrip van context en de verwerking van lange zinnen zijn meestal beter, ten koste van credits. Advies: vergelijk op dezelfde zin — vertaal die een keer met het lokale model en een keer met het cloudmodel, en houd degene die het beste bij jouw content past. Korte dialogen gratis op het lokale model en belangrijke hoofdstukken in de cloud is de gebruikelijke balans tussen kosten en kwaliteit.


