
AI अनुवाद सही नहीं? OCR पहचान विफलता और अनुवाद विफलता अलग करें
एक ही स्क्रीन ट्रांसलेशन टूल कल ठीक अनुवाद कर रहा था, आज अचानक पूरी स्क्रीन गलत अक्षरों से भर गई; या दोस्त के पास काफी सही चल रहा है, लेकिन आपने इस्तेमाल शुरू करते ही सब उलझ गया—ऐसी स्थिति में ज़्यादातर लोगों की पहली प्रतिक्रिया होती है "इस टूल का अनुवाद सही नहीं है"। यह निष्कर्ष बहुत जल्दी निकाला गया है। अनुवाद में गलती के दो पूरी तरह अलग स्रोत होते हैं: टेक्स्ट सही ढंग से पढ़ा नहीं गया, या सही पढ़ा गया लेकिन अनुवाद अच्छा नहीं हुआ। इन दोनों बातों को अलग करने पर ही निर्भुलता की समस्या पर बात की जा सकती है।
पहले अलग करें: पहचान विफलता और अनुवाद विफलता दो अलग चीज़ें हैं
स्क्रीन ट्रांसलेशन की प्रक्रिया दो चरणों में होती है: OCR पहले स्क्रीन पर मौजूद टेक्स्ट को संपादन योग्य टेक्स्ट में बदलता है, फिर AI अनुवाद उस टेक्स्ट को आपकी चुनी हुई भाषा में बदलता है। दोनों चरणों में से किसी एक में भी गड़बड़ होने पर आपको दिखने वाला अनुवाद गलत होगा, लेकिन ज़िम्मेदारी और समाधान का तरीका पूरी तरह अलग है।
अलग करने का तरीका क्लाइंट में ही मौजूद है: अनुवाद परिणाम के बगल में "पहचाना गया मूल टेक्स्ट" पैनल होता है, जो दिखाता है कि इस बार OCR ने असल में क्या टेक्स्ट पढ़ा। अगर पहचान पैनल में ही ढेर सारे गलत अक्षर हैं, तो समस्या पहचान की है—बॉक्स चयन और स्क्रीन की स्थिति ठीक करें; पहचाना गया मूल टेक्स्ट सही है लेकिन अनुवाद गलत है, तभी समस्या अनुवाद की है—मॉडल और शब्दावली समायोजित करें। काम शुरू करने से पहले एक नज़र देख लें, त्रुटि-निवारण की दिशा गलत नहीं होगी।
OCR पहचान विफलता के सामान्य कारण बस यही छह हैं
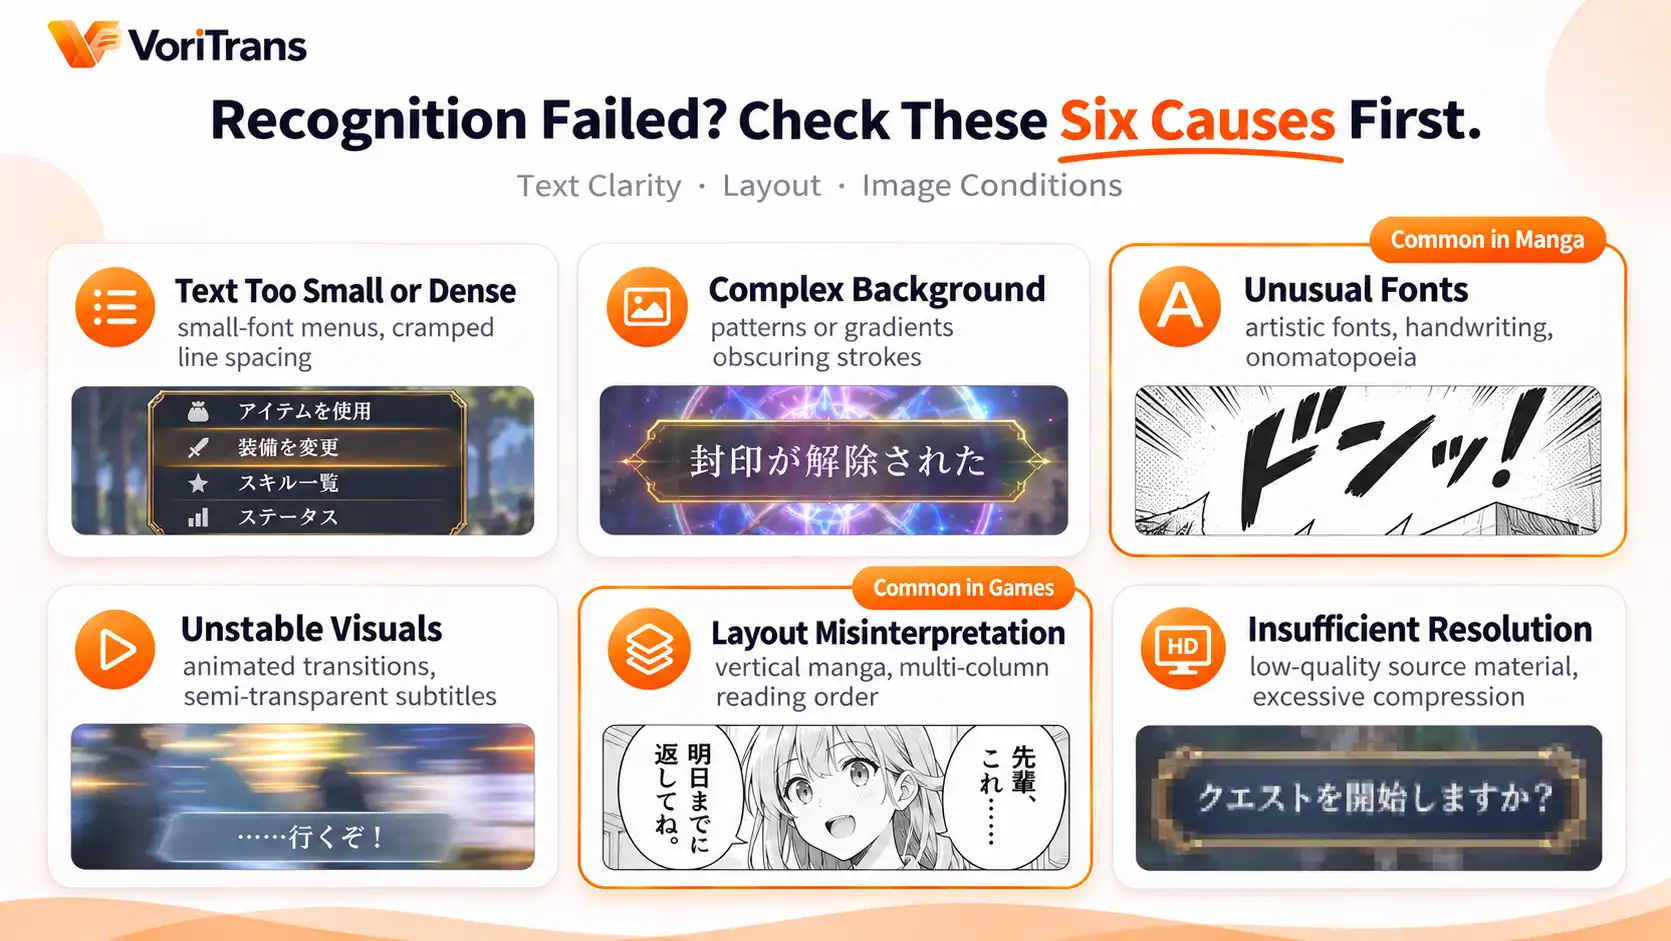
पहचान की गुणवत्ता टेक्स्ट की स्पष्टता, लेआउट और स्क्रीन की स्थिति पर निर्भर करती है—इस पैमाने से मापें, तो विफलता के परिदृश्य लगभग निम्नलिखित छह श्रेणियों में आ जाते हैं:
- टेक्स्ट बहुत छोटा या बहुत घना: गेम इंटरफ़ेस का छोटा टेक्स्ट, लाइनों के बीच कम जगह वाली मेनू सूची—अक्षर एक-दूसरे में चिपके रहते हैं, OCR सीमाएँ अलग नहीं कर पाता।
- जटिल पृष्ठभूमि: टेक्स्ट पैटर्न, ग्रेडिएंट, लाइट-शैडो इफ़ेक्ट पर होता है, अक्षरों की रेखाएँ और पृष्ठभूमि आपस में मिल जाती हैं।
- विशेष फ़ॉन्ट: कलात्मक टेक्स्ट, हाथ की लिखावट, विकृत ध्वन्यात्मक शब्द—अक्षरों की संरचना छपे फ़ॉन्ट से बहुत अलग होती है।
- अस्थिर स्क्रीन: पहचान के क्षण स्क्रीन हिल रही होती है—ट्रांज़िशन एनिमेशन, धीरे-धीरे आने-जाने वाले सबटाइटल—पढ़ा जाता है आधा पारदर्शी या अधूरा टेक्स्ट।
- गलत लेआउट पहचान: वर्टिकल कॉमिक, मल्टी-कॉलम लेआउट में पढ़ने का क्रम गलत तय होने पर, पहचाने गए वाक्यों का क्रम पूरी तरह बिगड़ जाता है।
- अपर्याप्त रेज़ोल्यूशन: लो-क्वालिटी वीडियो सोर्स, अत्यधिक कंप्रेस किए गए स्क्रीनशॉट, सिस्टम स्केलिंग से हुई धुंधलाहट—टेक्स्ट ही जब साफ नहीं दिखता, टूल भी स्वाभाविक रूप से साफ नहीं पढ़ पाता।
समाधान के तरीके: चार चरणों में त्रुटि-निवारण
कारण पता होने पर, समाधान है उसी के अनुसार सुधार करना। VoriTrans को उदाहरण मानें, तो त्रुटि-निवारण इस क्रम में किया जा सकता है:
चरण 1: बॉक्स चयन का दायरा छोटा करें। सिर्फ लक्षित टेक्स्ट के उस छोटे हिस्से को बॉक्स करें, पूरी स्क्रीन बॉक्स में न लें—जितना छोटा बॉक्स, उतना कम व्यवधान, उतनी ज़्यादा सटीक पहचान।
चरण 2: स्क्रीन स्थिर होने तक इंतज़ार करके अनुवाद करें। प्राथमिकता सेटिंग्स में "स्क्रीन स्थिरता प्रतीक्षा" को मिलीसेकंड के हिसाब से समायोजित किया जा सकता है, एनिमेशन सबटाइटल या ट्रांज़िशन इफ़ेक्ट ज़्यादा वाली सामग्री के लिए, टूल को स्क्रीन स्थिर होने तक इंतज़ार करवाकर तब पहचान कराएँ।

चरण 3: दूसरा OCR इंजन आज़माएँ। प्राथमिकता सेटिंग्स में 4 OCR इंजन में से चुनने का विकल्प है, एक ही स्क्रीन पर इंजन बदलकर फिर से कोशिश करें, परिणाम स्पष्ट रूप से अलग हो सकते हैं—कोई भी इंजन हर परिस्थिति में श्रेष्ठ नहीं होता, आपकी सामग्री के लिए जो सबसे स्थिर रहे उसी को स्थिर रूप से इस्तेमाल करें।
चरण 4: एकल पुनः प्रयास और शब्दावली सुधार। कुछ खास बॉक्स ठीक से पहचाने न जाएँ, तो "एकल अनुवाद" से छोटे दायरे में दोबारा कोशिश करें; बार-बार गलत पढ़े जाने वाले निश्चित शब्द (नाम, सिस्टम शब्द), "शब्दावली संग्रह" में OCR सुधार के उद्देश्य से मूल शब्द को सही वर्तनी में निश्चित करें, अगले अनुवाद में स्वतः लागू होगा।
अनुवाद सही न हो तो क्या करें: मॉडल, शब्दावली और सही अपेक्षाएँ
अगर पहचाना गया मूल टेक्स्ट सही है और समस्या अनुवाद चरण में है, तो समायोज्य चीज़ें कम नहीं। अनुवाद मॉडल के लिए पहले "लोकल मॉडल" इस्तेमाल करने पर कोई क्रेडिट खर्च नहीं होता, क्षमता सीमित है लेकिन जाँच के लिए उपयुक्त; संदर्भ समझ की ज़रूरत ज़्यादा वाले महत्वपूर्ण अनुभागों के लिए, क्लाउड मॉडल (Qwen, DeepSeek, GLM) पर जाकर एक ही वाक्य के अनुवादों की तुलना करें, अंतर आमतौर पर सीधे दिख जाता है, खर्च होने वाले क्रेडिट के नियम ऑफिशियल वेबसाइट के प्राइसिंग पेज के अनुसार हैं।
स्वर और नामों की समस्या दो चीज़ों के हवाले करें: प्राथमिकता सेटिंग्स में "गेम ट्रांसलेशन प्रॉम्प्ट" कस्टमाइज़ करके अनुवाद शैली तय की जा सकती है, ताकि अनुवाद मूल रचना के स्वर से मेल खाए; शब्दावली संग्रह मुख्य पात्रों के नाम और विशेष परिभाषा शब्दों को एकरूप अनुवाद में निश्चित करता है, पूरी रचना में सामंजस्य बना रहता है। अपेक्षाएँ भी सही रखें: AI अनुवाद का लक्ष्य है आपको कहानी की प्रगति सहजता से समझने में मदद करना, प्रकाशन-स्तर का बारीक अनुवाद नहीं—कुछ वाक्यों को संदर्भ और स्क्रीन के साथ मिलाकर समझना, सामान्य उपयोग का हिस्सा है, टूल का विफल होना नहीं। पहचान न होने की समस्या की और पृष्ठभूमि के लिए, पिछली स्क्रीन ट्रांसलेटर क्या है पोस्ट देखें।
कब संदेह करें कि समस्या स्क्रीन में ही है
त्रुटि-निवारण के अंत में, एक तरह की समस्या की जड़ टूल में नहीं होती: लो-क्वालिटी वीडियो सोर्स, सेंसर किए गए दृश्य, एन्क्रिप्टेड सामग्री, फुलस्क्रीन एक्सक्लूसिव मोड—स्क्रीन खुद पहचान-योग्य टेक्स्ट उपलब्ध नहीं कराती, कोई भी टूल इस्तेमाल करें, बात वही है। फुलस्क्रीन मोड में पहचान असामान्य होने पर, पहले विंडोड या बॉर्डरलेस मोड में बदलकर फिर कोशिश करें, यही ऑफिशियल द्वारा दिया गया मुख्य सुझाव है। इसके विपरीत, किसी टूल की असली क्षमता जाँचने के लिए भी साफ, स्थिर स्क्रीन से परीक्षण करना चाहिए: लोकल मॉडल फ्री क्रेडिट खर्च करता है, अतिथि उपयोगकर्ताओं के लिए प्रति माह 1,000, पंजीकरण के बाद 2,000, अपनी नियमित रूप से देखी जाने वाली सामग्री से एक रात परीक्षण चलाना, किसी भी समीक्षा से ज़्यादा भरोसेमंद है।
सामान्य प्रश्न
AI अनुवाद की निर्भुलता कितनी हो सकती है?
कोई एकरूप संख्या नहीं है, और होनी भी नहीं चाहिए—निर्भुलता टेक्स्ट की स्पष्टता, लेआउट और स्क्रीन की स्थिति पर निर्भर करती है, एक ही सामग्री को अलग तरीके से दिखाने पर परिणाम अलग होता है। ज़िम्मेदार टूल प्रतिशत का वादा नहीं करते; जो किया जा सकता है वह है "पहचाना गया मूल टेक्स्ट" पैनल आपके लिए खुला रखना, ताकि आप खुद मिलान कर सकें—पहचान सही होने पर फिर अनुवाद देखें, समस्या किस चरण में है एक नज़र में स्पष्ट।
एक ही शब्द बार-बार गलत पहचाने जाएँ तो क्या करें?
शब्दावली संग्रह का OCR सुधार इस्तेमाल करें: गलत पढ़े गए मूल शब्द और सही वर्तनी जोड़ें, अंग्रेज़ी बड़े-छोटे अक्षर नज़रअंदाज़ करने का विकल्प चुना जा सकता है, बदलाव के बाद अगले अनुवाद में स्वतः लागू होगा, हर बार मैन्युअली बदलना नहीं पड़ेगा। यह शब्दावली संग्रह इंपोर्ट-एक्सपोर्ट का समर्थन करता है, डिवाइस बदलने पर भी साथ ले जा सकते हैं।
क्लाउड मॉडल पर जाने से अनुवाद ज़्यादा सही होगा?
संदर्भ समझ और लंबे वाक्यों की प्रक्रिया आमतौर पर बेहतर होती है, बदले में क्रेडिट खर्च होता है। एक ही संवाद से तुलना करने की सलाह: लोकल मॉडल से एक बार अनुवाद करें, क्लाउड मॉडल से एक बार अनुवाद करें, आपकी सामग्री के लिए जो अंतर उपयुक्त हो वही इस्तेमाल करें—छोटे संवादों के लिए लोकल मॉडल फ्री चलाएँ, महत्वपूर्ण अनुभागों पर क्लाउड पर जाएँ, यही लागत और गुणवत्ता का सामान्य संतुलन है।


