
Точність AI-перекладу: правильно діагностуйте проблему та виправляйте її
Той самий інструмент перекладу екрана вчора працював добре, а сьогодні раптом суцільні помилки; або в друга він точний, а у ваших руках усе розсипається — більшість людей у такій ситуації спершу думає «цей інструмент перекладає неточно». Висновок занадто поспішний. У помилок перекладу два абсолютно різні джерела: або текст було неправильно розпізнано, або розпізнано правильно, але погано перекладено. Лише розділивши ці дві речі, можна говорити про проблему точності.
Спершу розділіть: збій розпізнавання і збій перекладу — різні речі
Переклад екрана складається з двох кроків: спочатку OCR перетворює текст на екрані на придатний для редагування текст, а потім AI-переклад переносить цей текст тією мовою, яку ви обрали. Якщо помиляється будь-який із кроків, переклад буде неправильним, але відповідальність і рішення — зовсім різні.
Спосіб розрізнити — у самому клієнті: поруч із результатом перекладу є панель «Розпізнаний оригінал», яка показує, що OCR насправді прочитав цього разу. Якщо сама панель розпізнавання сповнена помилок, проблема в розпізнаванні — виправляйте область виділення та умови екрана; якщо оригінал правильний, а переклад ні, проблема в перекладі — налаштовуйте модель і термінологію. Спершу гляньте цим оком, і напрям пошуку не зіб'ється.
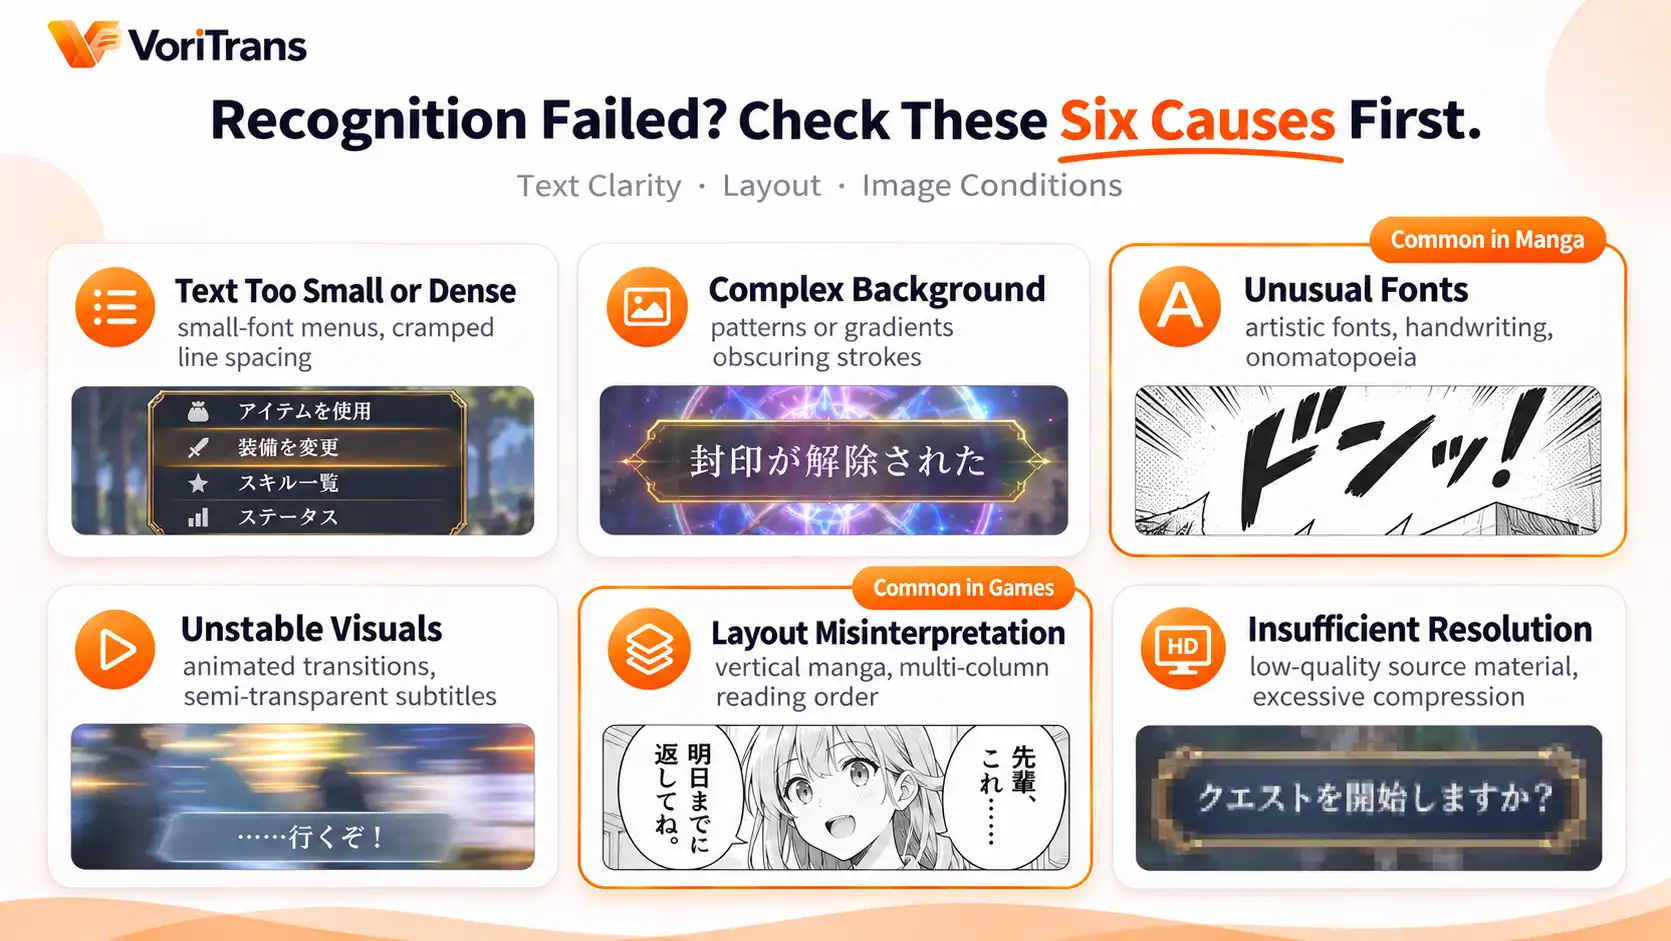
Шість типових причин збою розпізнавання OCR
Якість розпізнавання залежить від чіткості тексту, компонування та умов екрана — за цією міркою майже всі сценарії збою потрапляють у шість категорій нижче:
- Текст занадто дрібний або щільний: Дрібні шрифти інтерфейсу ігор, списки меню з тісними рядками; символи зливаються, і OCR не розрізняє меж.
- Складний фон: Текст лежить на візерунках, градієнтах, ефектах світла й тіні; штрихи зливаються з фоном.
- Незвичний шрифт: Художні шрифти, рукописний стиль, деформовані звуконаслідування; будова символів далека від друкованих.
- Нестабільне зображення: У момент розпізнавання картинка рухається — перехідні анімації, субтитри, що плавно з'являються і зникають; зчитуються напівпрозорі або неповні символи.
- Помилкове визначення компонування: У вертикальній манзі чи багатоколонковій верстці, якщо неправильно визначено порядок читання, порядок розпізнаних речень повністю плутається.
- Недостатня роздільність: Джерело відео низької якості, надміру стиснуті скриншоти, розмитість через масштабування системи; коли букв не видно й вам, інструмент, звісно, теж не прочитає їх чітко.
Відповідні рішення: чотири кроки
Коли причина відома, рішення лежить прямо навпроти неї. На прикладі VoriTrans пошук несправності можна вести в такому порядку:
Крок 1: звузьте область виділення. Виділіть лише маленьку ділянку з цільовим текстом, не захоплюйте весь екран — що менше виділення, то менше перешкод і точніше розпізнавання.
Крок 2: зачекайте стабільності зображення перед перекладом. У налаштуваннях є «Очікування стабільності екрана», яке регулюється в мілісекундах; для контенту з анімованими субтитрами та перехідними ефектами дайте інструменту дочекатися, поки картинка усталиться, і лише тоді розпізнавати.

Крок 3: спробуйте інший OCR-рушій. У налаштуваннях доступні 4 OCR-рушії на вибір; спробуйте те саме зображення з іншим рушієм — результат може помітно відрізнятися; жоден рушій не лідирує в усіх сценаріях, тож закріпіть той, що найстабільніший для вашого контенту.
Крок 4: разовий повтор і виправлення термінів. Якщо окремі блоки розпізнаються погано, скористайтеся «разовим перекладом», виділивши невелику область ще раз; а сталі слова, які постійно зчитуються неправильно (імена, системні терміни), закріпіть у «словнику термінів» через функцію виправлення OCR, вказавши правильне написання — наступного перекладу застосується автоматично.
Що робити, коли переклад неточний: модель, термінологія та правильні очікування
Якщо розпізнаний оригінал правильний, проблема на етапі перекладу, і тут теж чимало налаштувань. У моделі перекладу почніть із «локальної моделі» — вона не витрачає кредити, можливості обмежені, але годиться для перевірки; у важливих розділах, де потрібне розуміння контексту, перемикайтеся на хмарні моделі (Qwen, DeepSeek, GLM) і порівнюйте переклад того самого речення — різниця зазвичай видна одразу, а правила витрачання кредитів шукайте на офіційній сторінці цін.
Проблеми тону та імен вирішують дві речі: «промпт ігрового перекладу» в налаштуваннях дозволяє налаштувати стиль перекладу, щоб він відповідав тональності твору; словник термінів закріплює імена головних персонажів і власні терміни за єдиним перекладом, і твір лишається послідовним від початку до кінця. Виставте й правильні очікування: мета AI-перекладу — щоб ви вільно читали розвиток сюжету рідною мовою, а не видавничий рівень літературного перекладу — тлумачити окремі речення з опорою на контекст і картинку — це нормальний спосіб користування, а не збій інструмента. Більше передумов про помилки розпізнавання — у нашій попередній статті що таке перекладач екрана.
Коли варто підозрювати саме зображення
Після повного пошуку несправності існує клас проблем, корінь яких не в інструменті: відео низької якості, замозаєчені кадри, зашифрований контент, ексклюзивний повноекранний режим — саме зображення не дає тексту, який можна розпізнати, і будь-який інструмент покаже те саме. Якщо розпізнавання в повноекранному режимі дає збої, спершу перейдіть у віконний або безрамковий режим і спробуйте знову — це офіційна основна рекомендація. І навпаки: щоб перевірити справжній рівень інструмента, тестуйте його на чіткій, стабільній картинці: безкоштовні кредити, які витрачає локальна модель, — 1,000 на місяць для гостей і 2,000 після реєстрації; проганяйте їх вечір на контенті, який ви регулярно дивитеся, — це надійніше за будь-який огляд.
Часті запитання
Наскільки точним може бути AI-переклад?
Єдиної цифри немає, і її й не повинно бути — точність залежить від чіткості тексту, компонування та умов екрана; той самий контент дає інший результат при іншому способі показу. Відповідальний інструмент не обіцяє відсотків; він може відкрити вам панель «Розпізнаний оригінал» для самоперевірки: спершу переконайтеся, що розпізнано правильно, а тоді дивіться на переклад — і одразу видно, у якій ланці проблема.
Що робити, якщо одні й ті самі слова розпізнаються неправильно?
Скористайтеся виправленням OCR у словнику термінів: додайте оригінальне слово, що зчитується неправильно, і правильне написання; за потреби вмикайте ігнорування регістру англійських літер. Зміни застосовуються автоматично з наступного перекладу, без ручного виправлення щоразу. Словник підтримує імпорт/експорт, тож його можна перенести на новий пристрій.
Чи стане переклад точнішим після переходу на хмарну модель?
Зазвичай краще з розумінням контексту та обробкою довгих речень, ціною є витрачання кредитів. Порівняйте на одному й тому самому реченні діалогу: один переклад локальною моделлю, один — хмарною; якщо різниця пасує вашому контенту, обирайте її — короткі діалоги перекладати локальною моделлю безкоштовно, а в важливих розділах переходити на хмарну — типовий баланс між витратами та якістю.


