
Точность ИИ-перевода: как диагностировать и улучшить результаты
Один и тот же инструмент перевода с экрана: вчера переводил отлично, а сегодня вдруг весь текст в ошибках; или у друга работает точно, а у вас — сплошная путаница. В такой ситуации первая реакция большинства: «инструмент переводит неточно». Этот вывод делается слишком поспешно. У ошибок в переводе два совершенно разных источника: текст не был правильно распознан, либо распознан верно, но плохо переведён. Только разделив эти две вещи, можно осмысленно говорить о точности.
Сначала разделим: сбой распознавания и сбой перевода — разные вещи
Процесс перевода с экрана состоит из двух шагов: сначала OCR превращает текст с картинки в редактируемый текст, а затем ИИ-перевод переводит этот текст на выбранный вами язык. Если сбой случился на любом из шагов, перевод на экране будет неверным, но ответственность и решение совершенно разные.
Способ различить их есть в самом клиенте: рядом с результатом перевода находится панель «распознанный оригинал», где видно, какой текст OCR действительно считал в этот раз. Если в самой панели уже полно ошибок — проблема в распознавании: меняйте область выделения и условия картинки. Если оригинал распознан верно, а перевод неверный — проблема в переводе: настраивайте модель и термины. Сначала взгляните сюда, и диагностика не собьётся с пути.
Сбой распознавания OCR: всего шесть типичных причин
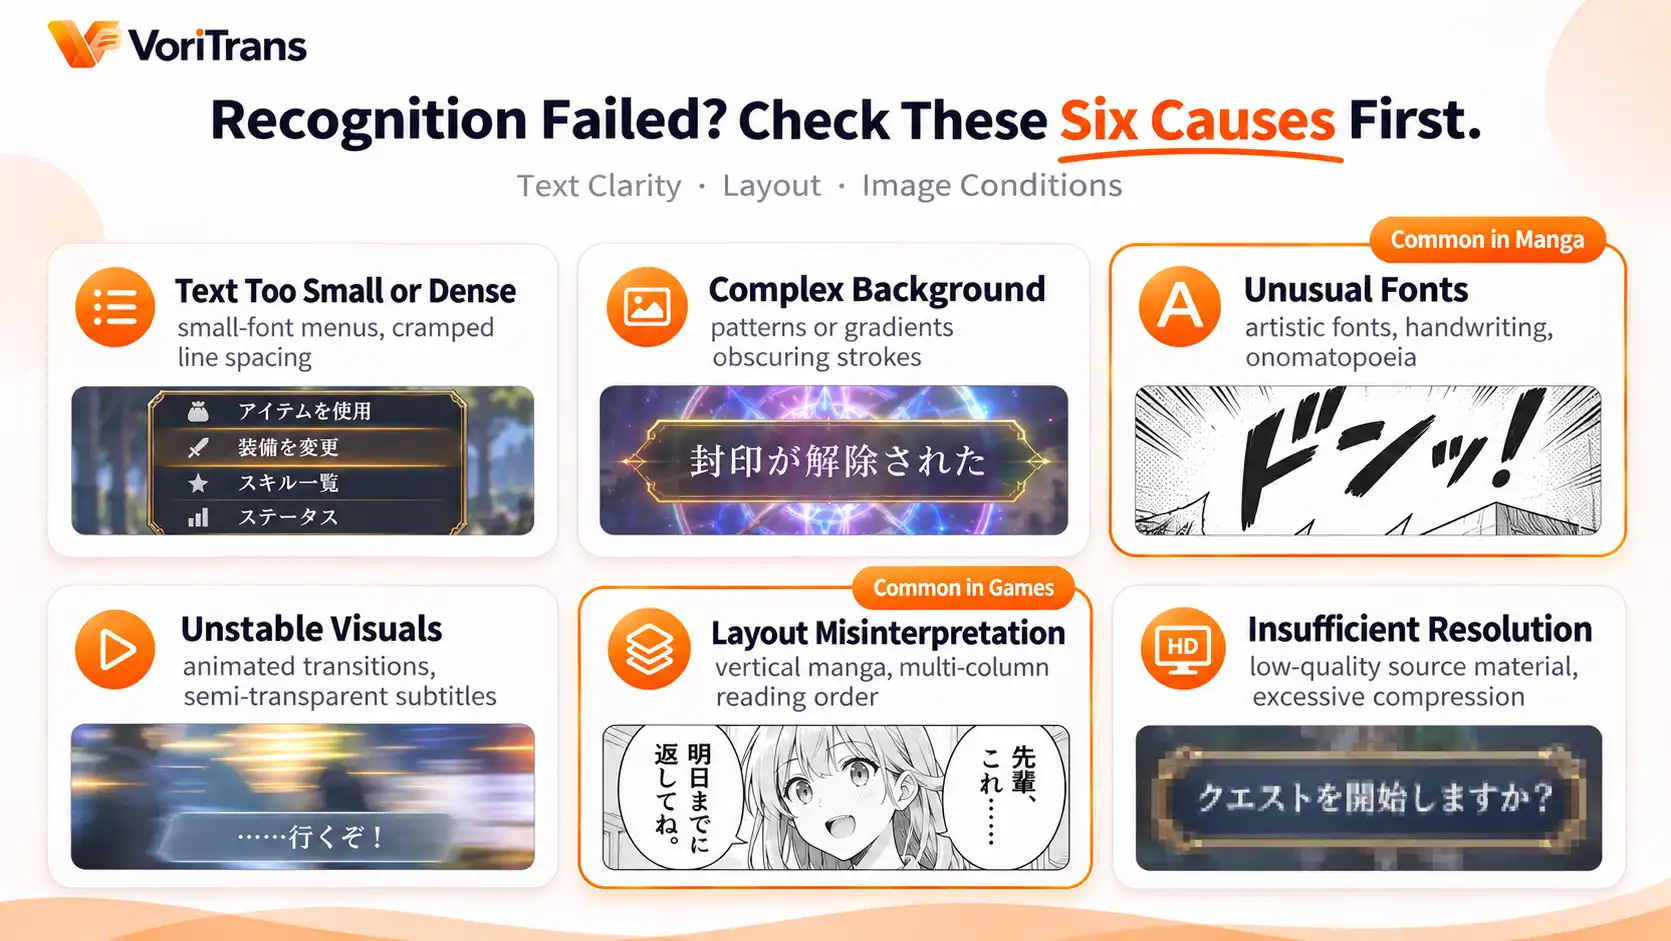
Качество распознавания зависит от чёткости текста, вёрстки и условий картинки — по этой мерке практически любой сбой попадает в одну из шести категорий:
- Текст слишком мелкий или плотный: мелкие надписи в игровых интерфейсах, списки меню с тесными межстрочными интервалами — символы слипаются, и OCR не видит границ.
- Сложный фон: текст лежит на узорах, градиентах и световых эффектах, штрихи сливаются с фоном.
- Нестандартные шрифты: художественные надписи, рукописный стиль, деформированные звукоподражания по структуре штрихов далеки от печатных шрифтов.
- Нестабильная картинка: в момент распознавания экран движется — переходные анимации, появляющиеся и исчезающие субтитры; считываются полупрозрачные или обрывочные символы.
- Ошибочно определённая вёрстка: в вертикальной манге или многоколоночной вёрстке при неверном порядке чтения последовательность распознанных фраз полностью перемешивается.
- Недостаточное разрешение: видео низкого качества, пережатые скриншоты, размытость из-за масштабирования системы — если букв не видите вы, инструмент их тоже не прочитает.
Как искать проблему: четыре шага
Когда причина известна, остаётся исправлять по пунктам. На примере VoriTrans диагностику можно вести в таком порядке:
Шаг 1: сузьте область выделения. Выделите только тот фрагмент, где находится нужный текст, а не весь экран — чем меньше область, тем меньше помех и точнее распознавание.
Шаг 2: дождитесь стабильности картинки перед переводом. В настройках есть параметр «ожидание стабилизации изображения», настраиваемый в миллисекундах; для контента с анимированными субтитрами и обильными переходными эффектами позвольте инструменту подождать, пока картинка устоится.

Шаг 3: смените OCR-движок. В настройках доступны 4 OCR-движка на выбор; попробуйте другой движок на той же картинке — результат может заметно отличаться. Ни один движок не лидирует во всех сценариях: зафиксируйте тот, что стабильнее всего работает с вашим контентом.
Шаг 4: разовый повтор и исправление терминов. Если отдельный фрагмент распознан плохо, воспользуйтесь «разовым переводом», выделив этот небольшой участок заново; для постоянных слов, которые всегда считываются неверно (имена собственные, системные надписи), задайте в «глоссарии терминов» исправление OCR, зафиксировав правильное написание исходного слова, — оно автоматически применится при следующем переводе.
Что делать при неточном переводе: модели, термины и верные ожидания
Если распознанный оригинал верен и проблема в переводе, настроек тоже немало. Для модели перевода начните с «локальной модели» — она не расходует кредиты, возможности скромнее, но годится для проверки; для важных глав, где важно понимание контекста, переключитесь на облачные модели (Qwen, DeepSeek, GLM) и сравните перевод одной и той же фразы — разница обычно видна сразу. Правила расхода кредитов смотрите на официальной странице цен.
С тоном и именами справляются две вещи: «игровой промпт перевода» в настройках позволяет задать стиль перевода под интонацию произведения, а глоссарий терминов закрепляет имена героев и собственные названия мира в едином варианте перевода, единообразном для всего произведения. Стоит и правильно настроить ожидания: цель ИИ-перевода — чтобы вы свободно следили за сюжетом, а не издательский уровень художественного перевода; разобрать отдельную фразу по контексту и картинке — это нормальный способ пользоваться инструментом, а не его сбой. Подробнее о причинах сбоев распознавания — в предыдущей статье что такое переводчик с экрана.
Когда стоит заподозрить саму картинку
В конце диагностики есть класс проблем, корень которых не в инструменте: видео низкого качества, кадры с цензурой-мозаикой, защищённый контент, эксклюзивный полноэкранный режим — сама картинка не содержит распознаваемого текста, и никакой инструмент не поможет. Если распознавание сбоит в полноэкранном режиме, сначала переключитесь в оконный или безрамочный режим и попробуйте снова — это официальная базовая рекомендация. И наоборот: чтобы проверить реальный уровень инструмента, тестируйте его на чёткой и стабильной картинке: локальная модель расходует бесплатные кредиты — 1 000 в месяц для гостей и 2 000 после регистрации; прогоните её вечер на контенте, который обычно смотрите, — это надёжнее любых обзоров.
Частые вопросы
Какой точности может достичь ИИ-перевод?
Единой цифры нет, и не должно быть — точность зависит от чёткости текста, вёрстки и условий картинки, и один и тот же материал при разном способе отображения даёт разные результаты. Ответственный инструмент не обещает процентов; он может открыть вам панель «распознанный оригинал», чтобы вы сами сверили текст: если распознавание верно, смотрите перевод — и сразу ясно, на каком этапе проблема.
Что делать, если одни и те же слова всегда распознаются неверно?
Используйте исправление OCR в глоссарии терминов: добавьте исходное слово, которое считывается неверно, и его правильное написание; можно отметить игнорирование регистра, и изменение автоматически применится при следующем переводе, без ручной правки каждый раз. Глоссарий поддерживает импорт и экспорт — при смене устройства его можно забрать с собой.
Будет ли точнее с облачной моделью?
Понимание контекста и работа с длинными фразами обычно лучше, но тратятся кредиты. Рекомендуется сравнить на одной и той же реплике: переведите её локальной моделью и облачной — и оставьте ту, что лучше подходит вашему контенту. Короткие диалоги бесплатно на локальной модели, важные главы в облаке — обычный баланс цены и качества.


