
Precisión de la traducción con IA: cómo diagnosticar y mejorar los resultados
Con la misma herramienta de traducción de pantalla, ayer funcionaba de maravilla y hoy de repente aparece llena de errores; o a un amigo le va muy bien y cuando tú la pruebas sale todo desordenado. Ante esta situación, la primera reacción de la mayoría es pensar «esta herramienta traduce mal». Esa conclusión llega demasiado rápido. Los errores de la traducción tienen dos orígenes completamente distintos: el texto no se leyó correctamente, o se leyó bien pero se tradujo mal. Solo separando estas dos cosas tiene sentido hablar de precisión.
Primero separemos: fallo de reconocimiento y fallo de traducción son cosas distintas
El flujo de la traducción de pantalla tiene dos pasos: el OCR convierte primero el texto de la imagen en texto editable, y la traducción con IA convierte después ese texto al idioma que hayas elegido. Si falla cualquiera de los dos pasos, la traducción que ves será incorrecta, pero la responsabilidad y la solución son totalmente diferentes.
La forma de distinguirlos está en el propio cliente: junto al resultado de la traducción hay un panel de «texto original reconocido» que muestra qué palabras leyó realmente el OCR en esa ocasión. Si ese panel ya está lleno de errores, el problema es del reconocimiento: ajusta el área seleccionada y las condiciones de la imagen. Si el texto original es correcto pero la traducción no, entonces el problema es de la traducción: cambia el modelo y los términos. Mira esto primero antes de actuar y no te desviarás en el diagnóstico.
Fallo de reconocimiento OCR: las causas habituales son solo seis
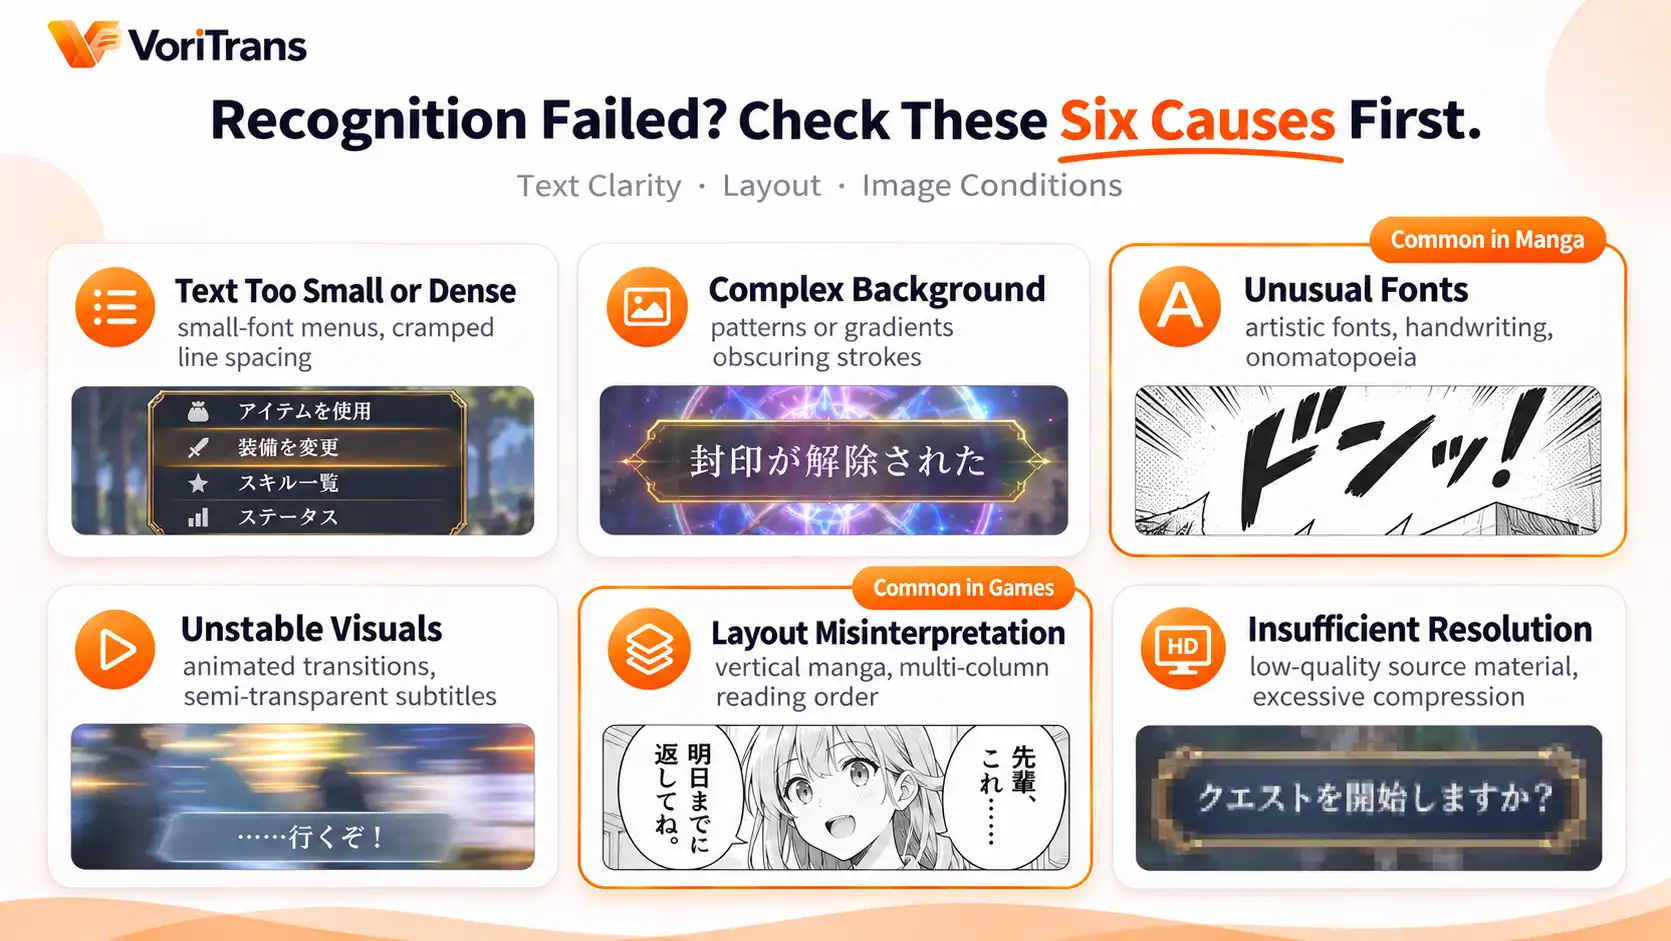
La calidad del reconocimiento depende de la nitidez del texto, de la disposición y de las condiciones de la imagen. Medido con esa regla, casi todos los casos de fallo caben en estas seis categorías:
- Texto demasiado pequeño o denso: las letras pequeñas de las interfaces de juego o los menús con poco interlineado hacen que los caracteres se peguen y el OCR no distingue los límites.
- Fondo complejo: el texto se superpone a patrones, degradados o efectos de luz, y los trazos se mezclan con el fondo.
- Tipografías especiales: las letras artísticas, la escritura a mano o las onomatopeyas deformadas tienen estructuras de trazo muy alejadas de las fuentes impresas.
- Imagen inestable: la pantalla se mueve en el momento del reconocimiento: animaciones de transición o subtítulos que aparecen y desaparecen con fundido; se leen letras semitransparentes o incompletas.
- Disposición mal interpretada: en manga vertical o maquetaciones de varias columnas, si el orden de lectura se calcula mal, el orden de las frases reconocidas se desordena por completo.
- Resolución insuficiente: vídeos en baja calidad, capturas sobrecomprimidas o desenfoque por el escalado del sistema: si tú mismo no distingues las letras, la herramienta tampoco podrá leerlas.
Cómo solucionarlo: cuatro pasos
Si conoces la causa, la solución es corregir punto por punto. Tomando VoriTrans como ejemplo, el diagnóstico puede seguir este orden:
Paso 1: reduce el área de selección. Encuadra solo el trozo donde está el texto que te interesa, no toda la pantalla: cuanto más pequeño el encuadre, menos interferencias y más preciso el reconocimiento.
Paso 2: espera a que la imagen se estabilice antes de traducir. En las preferencias hay una opción de «espera de estabilización de imagen» ajustable en milisegundos; en contenidos con subtítulos animados o muchos efectos de transición, deja que la herramienta espere a que la imagen se asiente antes de reconocer.

Paso 3: cambia de motor OCR. Las preferencias ofrecen 4 motores OCR entre los que elegir; prueba con otro motor sobre la misma imagen y el resultado puede cambiar de forma notable: ningún motor gana en todos los escenarios, quédate con el que funcione más estable con tu contenido.
Paso 4: reintento puntual y corrección de términos. Si alguna zona se reconoce mal, usa la opción de «traducción única» encuadrando esa zona pequeña y vuelve a intentarlo; con las palabras fijas que siempre se leen mal (nombres propios, términos del sistema), usa la función de corrección OCR del glosario de términos para fijar la escritura correcta, y surtirá efecto automáticamente en la siguiente traducción.
¿Qué hacer cuando la traducción no es buena: modelos, términos y expectativas correctas
Si el texto original reconocido es correcto y el problema está en la traducción, también hay bastantes cosas que ajustar. Para el modelo de traducción, empieza por el «modelo local», que no consume créditos: sus capacidades son limitadas pero sirve para verificar; en capítulos importantes donde se exige buena comprensión del contexto, cambia a los modelos en la nube (Qwen, DeepSeek, GLM) y compara la traducción de la misma frase: la diferencia suele notarse a simple vista. Las reglas de consumo de créditos se rigen por la página de precios oficial.
El tono y los nombres propios se resuelven con dos cosas: el «prompt de traducción de juegos» de las preferencias permite personalizar el estilo de la traducción para que se ajuste al tono de la obra, y el glosario de términos fija los nombres de los protagonistas y los términos propios del mundo en una traducción uniforme, coherente en toda la obra. También conviene ajustar las expectativas: el objetivo de la traducción con IA es que sigas la historia sin trabas, no una traducción editorial de nivel profesional; interpretar alguna frase aislada con el contexto y la imagen en la mano es un uso normal, no un fallo de la herramienta. Para más contexto sobre los fallos de reconocimiento, puedes consultar el artículo anterior qué es un traductor de pantalla.
Cuándo sospechar que el problema es la propia imagen
Al final del diagnóstico hay un tipo de problema cuya raíz no está en la herramienta: fuentes en baja calidad, imágenes censuradas con mosaico, contenidos cifrados o el modo exclusivo de pantalla completa: la propia imagen no ofrece texto reconocible, y ninguna herramienta lo resolverá. Si el reconocimiento falla en pantalla completa, cambia primero a modo ventana o sin bordes y vuelve a probar: es la recomendación habitual oficial. Dicho al revés, para comprobar el nivel real de una herramienta también hay que probarla con imágenes nítidas y estables: el modelo local consume créditos gratuitos — 1.000 al mes para visitantes y 2.000 tras registrarte —; pruébalo una noche con el contenido que sueles ver y eso vale más que cualquier reseña.
Preguntas frecuentes
¿Qué precisión puede alcanzar la traducción con IA?
No hay una cifra única, ni debería haberla: la precisión depende de la nitidez del texto, de la disposición y de las condiciones de la imagen, y el mismo contenido da resultados distintos según cómo se muestre. Una herramienta responsable no promete porcentajes; lo que puede hacer es abrirte el panel de «texto original reconocido» para que lo compruebes tú mismo: si el reconocimiento está bien, mira después la traducción, y así se ve de inmediato en qué eslabón está el problema.
¿Qué hacer si siempre se reconocen mal las mismas palabras?
Usa la corrección OCR del glosario de términos: añade la palabra original mal leída junto con su escritura correcta; puedes marcar la opción de ignorar mayúsculas y minúsculas, y el cambio surte efecto automáticamente en la siguiente traducción, sin correcciones manuales cada vez. El glosario admite importación y exportación, así que puedes llevártelo al cambiar de dispositivo.
¿Traducirá mejor si cambio a un modelo en la nube?
La comprensión del contexto y el manejo de frases largas suelen ser mejores, a cambio de consumir créditos. Se recomienda comparar con la misma frase: tradúcela con el modelo local y con el modelo en la nube, y quédate con el que mejor se adapte a tu contenido: diálogos cortos gratis con el modelo local y capítulos importantes en la nube es el equilibrio habitual entre coste y calidad.


