دقت ترجمه هوش مصنوعی: مشکل را درست تشخیص دهید و رفع کنید
ابزار ترجمه صفحه یکی است، دیروز خوب کار میکرد و امروز ناگهان پر از غلط است؛ یا برای دوستتان دقیق درمیآید و در دست شما به هم میریزد — نخستین واکنش بیشتر مردم در این وضعیت این است که «این ابزار درست ترجمه نمیکند». این نتیجهگیری عجولانه است. خطای ترجمه دو منبع کاملاً متفاوت دارد: یا متن درست خوانده نشده، یا درست خوانده شده ولی بد ترجمه شده. وقتی این دو را از هم جدا کنید، بحث درباره مسئله دقت معنا پیدا میکند.
اول جدا کنید: خطای شناسایی و خطای ترجمه یک چیز نیستند
ترجمه صفحه در دو گام انجام میشود: ابتدا OCR متن روی صفحه را به متن قابل ویرایش تبدیل میکند و سپس ترجمه هوش مصنوعی همان متن را به زبان دلخواه شما میبرد. اگر هر یک از این دو گام خطا داشته باشد، ترجمهای که میبینید نادرست است؛ اما مسئولیت و راهحل کاملاً متفاوتاند.
راه تشخیص در خود برنامه است: کنار نتیجه ترجمه، پنل «متن اصلی شناساییشده» وجود دارد که نشان میدهد OCR این بار واقعاً چه متنی خوانده است. اگر خودِ پنل شناسایی پر از غلط باشد، مشکل از شناسایی است و باید ناحیه انتخاب و شرایط تصویر را اصلاح کنید؛ اگر متن اصلی درست و ترجمه نادرست باشد، مشکل از ترجمه است و باید مدل و اصطلاحات را تنظیم کنید. پیش از دست به کار شدن این یک نگاه را بیندازید تا مسیر عیبیابی منحرف نشود.
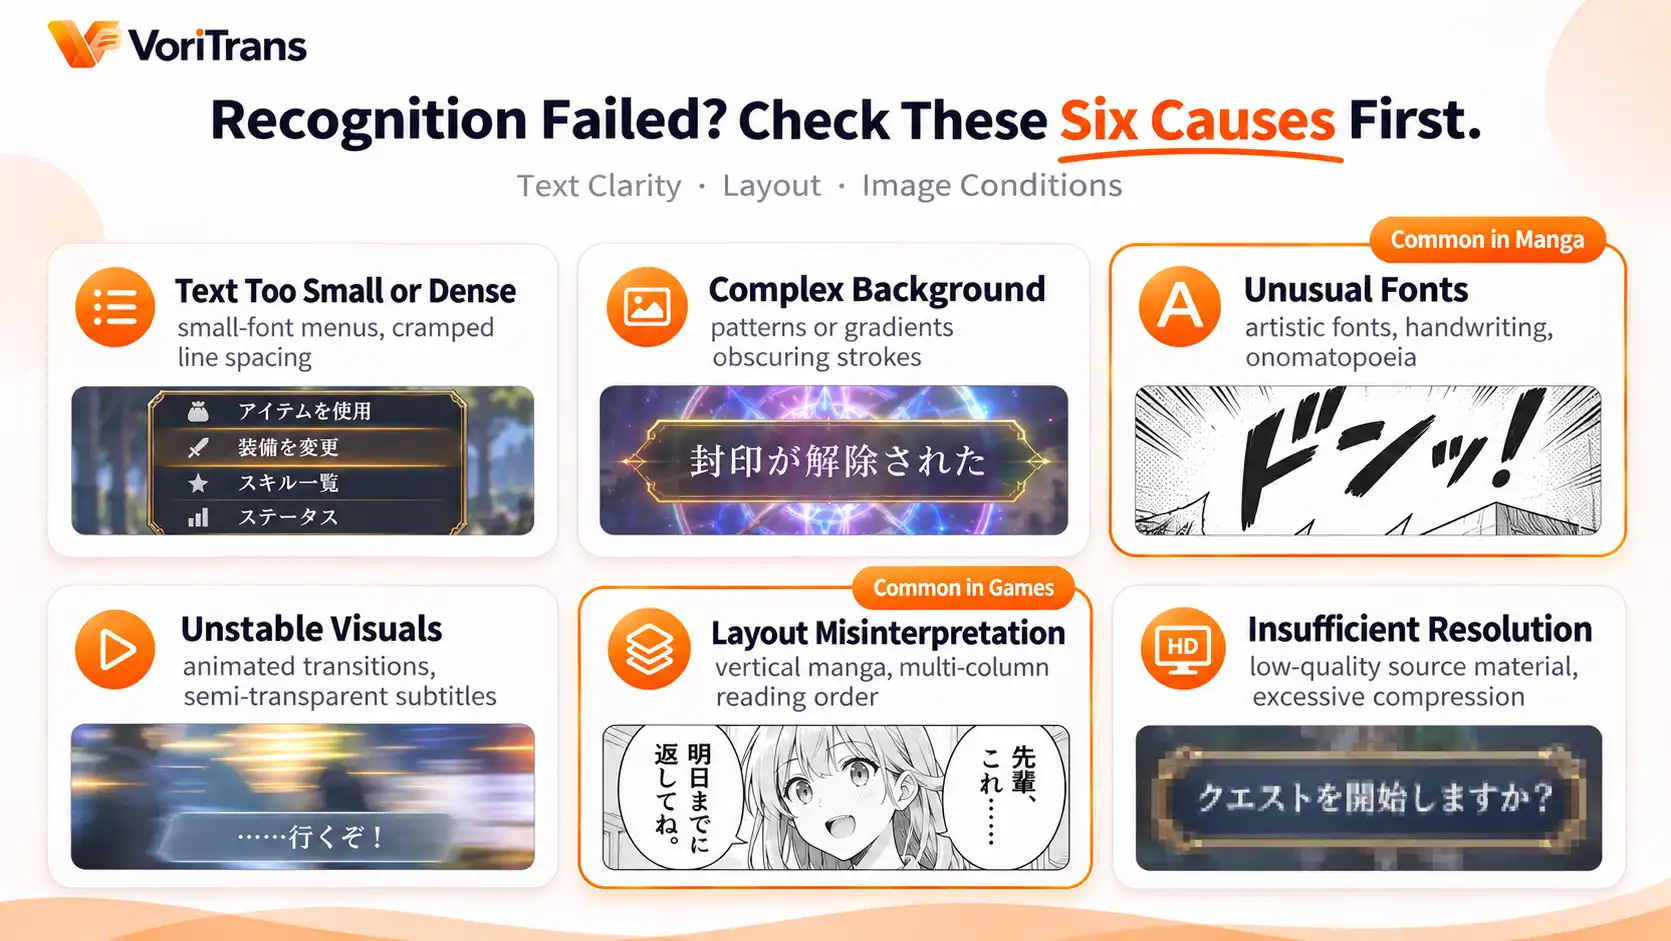
شش علت رایج خطای شناسایی OCR
کیفیت شناسایی به وضوح متن، چیدمان و شرایط تصویر بستگی دارد — با این معیار، تقریباً همه سناریوهای شکست در شش دسته زیر جای میگیرند:
- متن خیلی ریز یا خیلی متراکم: نوشتههای ریز رابط بازی و فهرستهای منو با فاصله خط کم؛ حروف به هم میچسبند و OCR مرزها را تشخیص نمیدهد.
- پسزمینه پیچیده: متن روی نقشونگار، گرادیان و جلوههای نور و سایه میافتد و خطوط با پسزمینه در هم میآمیزد.
- فونت غیرمتعارف: خطهای هنری، دستنویس و آواکشیهای دفرمه؛ ساختار حروف با چاپی فاصله زیادی دارد.
- تصویر ناپایدار: در لحظه شناسایی تصویر در حرکت است — انیمیشنهای گذر و زیرنویسهایی که بهتدریج ظاهر و محو میشوند؛ حروف نیمهشفاف یا ناقص خوانده میشود.
- تشخیص غلط چیدمان: در مانگای عمودی یا صفحهآرایی چندستونه، اگر ترتیب خواندن اشتباه تشخیص داده شود ترتیب جملههای شناساییشده کاملاً به هم میریزد.
- رزولوشن ناکافی: منبع ویدیوی کمکیفیت، اسکرینشاتهای بیشازحد فشرده و تاری ناشی از مقیاس سیستم؛ وقتی خودتان حروف را واضح نمیبینید، طبیعی است که ابزار هم ناخوانا ببیند.
راهحل متناظر: چهار مرحله
وقتی علت را میدانید، راهحل مستقیماً مقابل آن است. با مثال VoriTrans، عیبیابی را میتوانید به این ترتیب انجام دهید:
مرحله 1: محدوده انتخاب را کوچک کنید. فقط همان بخش کوچکِ متن هدف را کادر بکشید و کل تصویر را انتخاب نکنید — هرچه کادر کوچکتر، تداخل کمتر و شناسایی دقیقتر.
مرحله 2: منتظر ثبات تصویر بمانید و بعد ترجمه کنید. در تنظیمات، گزینه «انتظار برای ثبات تصویر» وجود دارد که بر حسب میلیثانیه قابل تنظیم است؛ در محتوای پر از زیرنویس متحرک و جلوههای گذر، بگذارید ابزار تا ثابتشدن تصویر صبر کند و بعد شناسایی کند.

مرحله 3: موتور OCR دیگری را امتحان کنید. تنظیمات، 4 موتور OCR برای انتخاب فراهم میکند؛ همان تصویر را با موتور دیگری دوباره امتحان کنید، نتیجه ممکن است آشکارا متفاوت باشد — هیچ موتوری در همه سناریوها برتر نیست، همان که برای محتوای شما پایدارترین است را ثابت نگه دارید.
مرحله 4: تلاش تکباره و اصلاح اصطلاحات. اگر کادرهای خاصی خوب شناسایی نمیشوند با «ترجمه تکباره» محدوده کوچکی را دوباره بگیرید؛ واژههای ثابتی که همیشه بد خوانده میشوند (نام اشخاص، واژههای سیستمی) را در «واژهنامه اصطلاحات» با کاربرد اصلاح OCR به شکل درست ثابت کنید تا در ترجمه بعدی خودکار اعمال شود.
اگر ترجمه دقیق نیست چه کنیم: مدل، اصطلاحات و انتظار درست
اگر متن اصلی شناساییشده درست است، مشکل در مرحله ترجمه است و اینجا هم جای تنظیم فراوان است. در مدل ترجمه اول از «مدل محلی» استفاده کنید که امتیاز مصرف نمیکند؛ تواناییاش محدود است اما برای راستیآزمایی مناسب است؛ در بخشهای مهم که درک بافت لازم است به مدلهای ابری (Qwen، DeepSeek، GLM) بروید و ترجمه جمله یکسان را مقایسه کنید؛ تفاوت معمولاً مستقیم دیده میشود و قواعد مصرف امتیاز در صفحه قیمت رسمی آمده است.
مشکل لحن و نام اشخاص را دو چیز حل میکند: «پرامپت ترجمه بازی» در تنظیمات امکان سفارشیسازی سبک ترجمه را میدهد تا ترجمه به حالوهوای اثر نزدیک شود؛ واژهنامه اصطلاحات نام شخصیتهای اصلی و واژههای خاص اثر را به یک ترجمه ثابت تثبیت میکند تا کل اثر یکدست بماند. انتظارتان را هم درست تنظیم کنید: هدف ترجمه هوش مصنوعی این است که روند داستان را به زبان خودتان روان بخوانید، نه ترجمه کتابی در سطح نشر — تفسیر تکتک جملهها با توجه به بافت و تصویر، روش استفاده عادی است نه خرابی ابزار. برای پیشزمینه بیشتر درباره خطای شناسایی، مقاله قبلی ما مترجم صفحه چیست را ببینید.
چه زمانی باید به خود تصویر مشکوک شویم؟
در پایان عیبیابی، دستهای از مشکلات ریشه در ابزار ندارد: منبع ویدیوی کمکیفیت، تصویر سانسورشده، محتوای رمزنگاریشده و حالت تمامصفحه انحصاری — خود تصویر متنی قابل شناسایی فراهم نمیکند و هر ابزاری همین وضع را دارد. وقتی شناسایی در حالت تمامصفحه اختلال دارد، اول به حالت پنجرهای یا بدون قاب بروید و دوباره امتحان کنید؛ این توصیه رایج رسمی است. برعکس، برای سنجش توان واقعی یک ابزار هم با تصویر واضح و پایدار تستش کنید: امتیازهای رایگانی که مدل محلی مصرف میکند برای مهمان ماهی 1,000 و پس از ثبتنام 2,000 است؛ یک شب با محتوای همیشگی خودتان تستش کنید از هر بررسیای مطمئنتر است.
سؤالات متداول
دقت ترجمه هوش مصنوعی چقدر است؟
عدد یکسانی وجود ندارد و نبودنش هم درست است — دقت به وضوح متن، چیدمان و شرایط تصویر بستگی دارد و همین محتوا با شیوه نمایش دیگر نتیجهاش عوض میشود. ابزار مسئول درصدی وعده نمیدهد؛ کاری که میتواند بکند بازکردن پنل «متن اصلی شناساییشده» برای راستیآزمایی خودتان است: اول درستی شناسایی را ببینید بعد سراغ ترجمه بروید، تا معلوم شود مشکل در کدام حلقه است.
همیشه همان دسته واژهها بد خوانده میشود، چه کنم؟
از اصلاح OCR در واژهنامه اصطلاحات استفاده کنید: واژه اصلی که بد خوانده شده و شکل درستش را اضافه کنید؛ امکان فعالکردن نادیدهگرفتن بزرگی/کوچکی حروف انگلیسی هم هست. تغییر در ترجمه بعدی خودکار اعمال میشود و لازم نیست هر بار دستی اصلاح کنید. این واژهنامه درونریزی و برونبری را پشتیبانی میکند و هنگام تعویض دستگاه هم با خودتان میبرید.
تغییر به مدل ابری ترجمه دقیقتری میدهد؟
معمولاً در درک بافت و پردازش جملههای بلند بهتر است، بهای آن مصرف امتیاز است. پیشنهاد میکنیم با یک جمله گفتگوی واحد مقایسه کنید: یکبار با مدل محلی و یکبار با مدل ابری؛ اگر تفاوت برای محتوای شما مناسب بود همان را انتخاب کنید — ترجمه رایگان گفتگوهای کوتاه با مدل محلی و رفتن به مدل ابری در بخشهای مهم، راه تعادل رایج هزینه و کیفیت است.