
AI 翻譯不準?先分清 OCR 識別失敗與翻譯失敗
同一款螢幕翻譯工具,昨天翻得好好的,今天突然滿屏錯字;或者朋友用著挺準,自己一上手就亂七八糟——遇到這種情況,多數人的第一反應是「這工具翻譯得不準」。這個結論下得太快了。譯文出錯有兩種完全不同的來源:文字沒被正確讀出來,或者讀對了但翻得不好。把這兩件事拆開,準確率問題才有得聊。
先拆開:識別失敗和翻譯失敗是兩回事
螢幕翻譯的流程分兩步:OCR 先把畫面上的文字變成可編輯的文字,AI 翻譯再把這個文字轉成目標語言。兩步任何一步出錯,你看到的譯文都會不對,但責任和解決辦法完全不同。
區分辦法就在用戶端裡:翻譯結果旁邊有一個「識別原文」面板,顯示這次 OCR 實際讀出了什麼文字。識別面板裡就已經錯字連篇,那是識別的問題,去改框選和畫面條件;識別原文正確、譯文不對,才是翻譯的問題,去調模型和術語。先看這一眼再動手,排查方向不會跑偏。
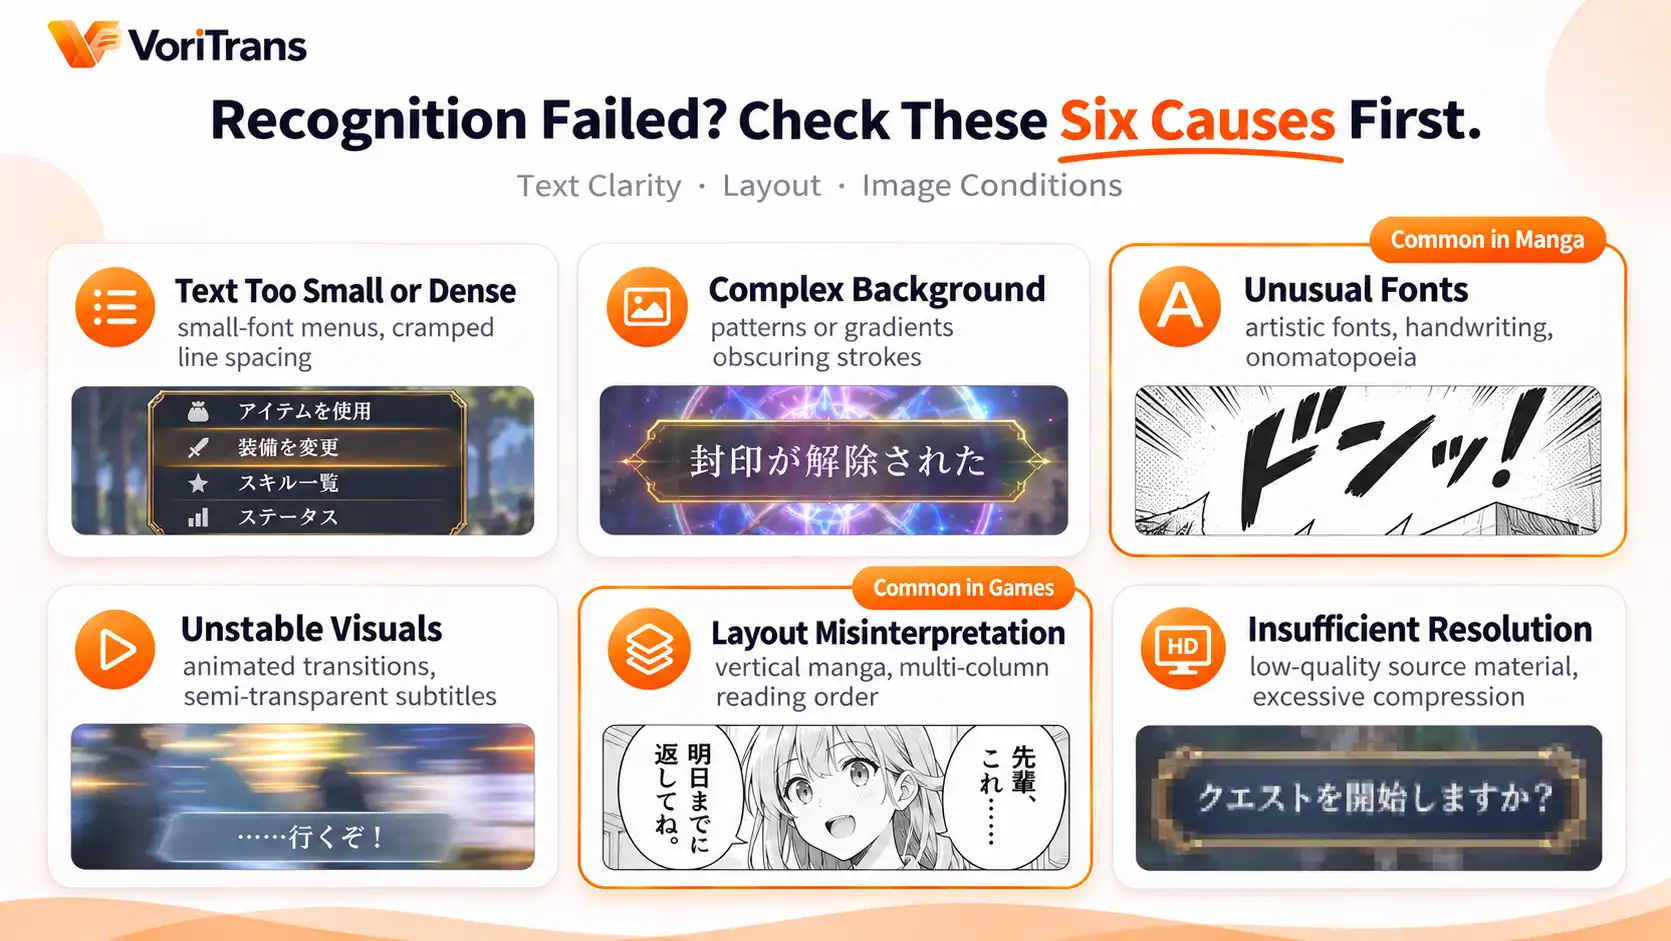
OCR 識別失敗,常見原因就這六種
識別效果取決於文字清晰度、版面和畫面條件——按這把尺子衡量,失敗情境基本都能歸進下面六類:
- 文字太小或太密:遊戲介面的小字、行距緊的選單列表,字元之間黏在一起,OCR 分不清邊界。
- 背景複雜:文字壓在花紋、漸層、光影特效上,筆畫和背景混在一起。
- 字型特殊:藝術字、手寫體、變形的擬聲詞,筆畫結構和印刷體差得遠。
- 畫面不穩定:識別的瞬間畫面在動——過場動畫、漸入漸出的字幕,讀到的是半透明或殘缺的字。
- 版面判斷錯:直排漫畫、多欄排版一旦閱讀順序判斷錯,識別出來的句子順序就全亂了。
- 解析度不足:低畫質片源、過度壓縮的截圖、系統縮放導致的模糊,字都看不清,工具自然也讀不清。
對應的排查辦法,四步走
知道原因,辦法就是對著改。以 VoriTrans 為例,排查可以按這個順序做:
第 1 步:縮小框選範圍。只框住目標文字那一小塊,別把整個畫面都框進去——框得越小,干擾越少,識別越準。
第 2 步:等畫面穩定再翻。偏好設定裡有「畫面穩定等待」可以按毫秒調,動畫字幕、過場特效多的內容,讓工具等畫面定下來再識別。

第 3 步:換一個 OCR 引擎。偏好設定提供 4 個 OCR 引擎可選,同一畫面換引擎再試,結果可能明顯不同——沒有哪個引擎全情境領先,你的內容哪種最穩就固定用哪種。
第 4 步:單次重試加術語糾錯。個別格子識別不好,用「單次翻譯」框小範圍再來一次;總被讀錯的固定詞(人名、系統詞),在「術語詞庫」裡用 OCR 糾錯用途把原詞固定成正確寫法,下一次翻譯自動生效。
翻譯不準怎麼辦:模型、術語與正確預期
如果識別原文是對的,問題出在翻譯環節,可調的地方同樣不少。翻譯模型先用「本地模型」不消耗點數,能力有限但適合驗證;語境理解要求高的重要章節,切到雲端模型(Qwen、DeepSeek、GLM)對比同一句話的譯文,差別通常能直接看出來,消耗的點數規則以官網價格頁為準。
語氣和人名的問題交給兩樣東西:偏好設定裡的「遊戲翻譯提示詞」可以自訂翻譯風格,讓譯文貼近作品的語氣;術語詞庫把主角名字、專有設定詞固定成統一譯法,整部作品前後一致。預期也要擺正:AI 翻譯的目標是讓你順暢讀懂劇情推進,不是出版級精翻——個別句子結合上下文和畫面理解,屬於正常使用方式而不是工具失靈。識別不準的更多背景,可以參考之前那篇什麼是螢幕翻譯器。
什麼時候該懷疑是畫面本身
排查到最後,有一類問題根源不在工具:低畫質片源、打了碼的畫面、加密內容、全螢幕獨占模式——畫面本身就提供不了可識別的文字,換什麼工具都一樣。全螢幕模式識別異常時,先切視窗化或無邊框模式再試,這是官方給的主流建議。反過來說,驗證一款工具的真實水準,也要用清晰、穩定的畫面去測:本地模型消耗免費點數,訪客每月 1,000、註冊後 2,000,拿自己常看的內容跑一晚,比任何評測都靠譜。
常見問題
AI 翻譯準確率能達到多少?
沒有統一數字,也不該有——準確率取決於文字清晰度、版面和畫面條件,同一段內容換種顯示方式結果就不同。負責任的工具不會承諾百分比;能做的是把「識別原文」面板開放給你自己核對,識別對了再看翻譯,問題出在哪一環一目瞭然。
總是識別錯同一批詞怎麼辦?
用術語詞庫的 OCR 糾錯:把被讀錯的原詞和正確寫法加進去,可勾選忽略英文大小寫,修改後下一次翻譯自動生效,不用每次手動改。這個詞庫支援匯入匯出,換裝置也能帶走。
換雲端模型會翻得更準嗎?
語境理解和長句處理通常更好,代價是消耗點數。建議用同一句對白做對比:本地模型翻一遍、雲端模型翻一遍,差別適合你的內容就用哪種——短對話用本地模型免費跑,重要章節切雲端,是成本和品質的常見平衡方式。


