
Precisão da tradução com IA: como diagnosticar e melhorar os resultados
Com a mesma ferramenta de tradução de tela, ontem tudo saía bem e hoje, de repente, a tradução aparece cheia de erros; ou um amigo usa com precisão e quando você testa, sai tudo embaralhado. Diante disso, a primeira reação da maioria é pensar: “essa ferramenta traduz mal”. Essa conclusão é apressada. Os erros na tradução têm duas origens totalmente diferentes: o texto não foi lido corretamente, ou foi lido certo, mas traduzido mal. Só separando essas duas coisas faz sentido falar de precisão.
Primeiro, separe: falha de reconhecimento e falha de tradução são coisas diferentes
O fluxo da tradução de tela tem duas etapas: o OCR primeiro transforma o texto da imagem em texto editável, e a tradução com IA depois converte esse texto para o idioma que você escolher. Se qualquer uma das etapas falhar, a tradução que você vê sai errada, mas a responsabilidade e a solução são completamente distintas.
O jeito de distinguir está no próprio cliente: ao lado do resultado da tradução há um painel de “texto original reconhecido”, que mostra o que o OCR leu de fato naquela vez. Se esse painel já está cheio de erros, o problema é de reconhecimento: ajuste a área selecionada e as condições da imagem. Se o texto original está certo e a tradução não, o problema é da tradução: ajuste o modelo e os termos. Olhe isso primeiro antes de agir, e a investigação não sai do rumo.
Falha de reconhecimento do OCR: as causas comuns são só seis
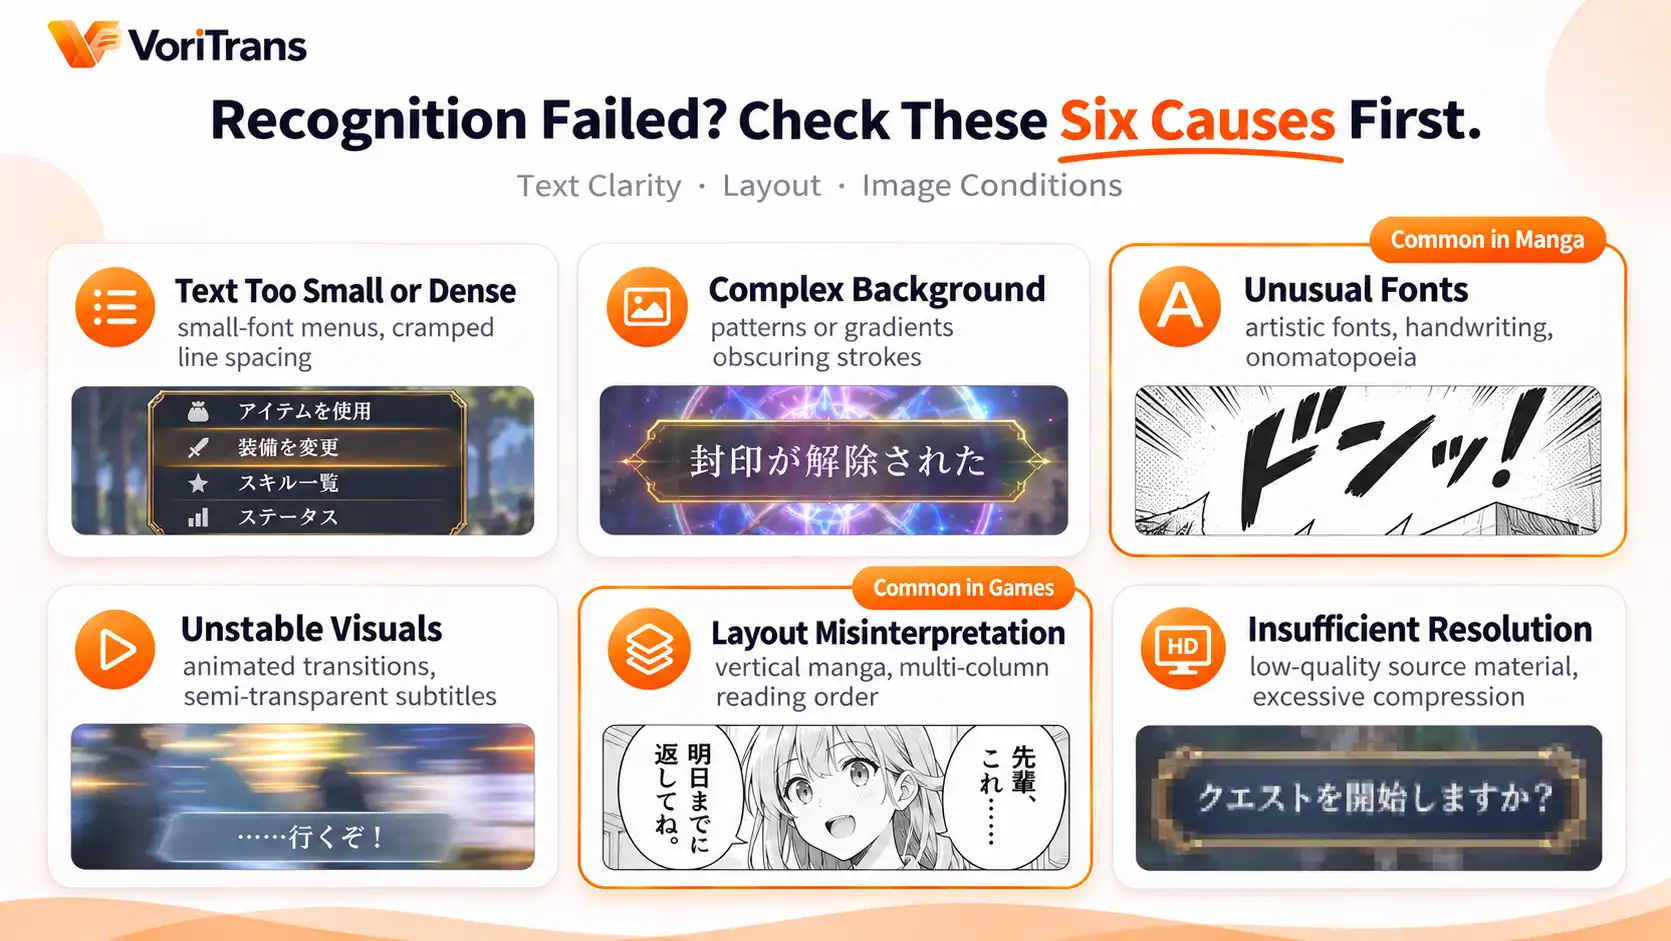
A qualidade do reconhecimento depende da nitidez do texto, do layout e das condições da imagem — medindo com essa régua, praticamente todos os casos de falha se encaixam nas seis categorias abaixo:
- Texto muito pequeno ou denso: letras miúdas de interfaces de jogos, listas de menu com entrelinhas apertadas — os caracteres se encostam e o OCR não distingue os limites.
- Fundo complexo: o texto fica sobre estampas, degradês ou efeitos de luz, e os traços se misturam ao fundo.
- Fontes especiais: letras artísticas, manuscritas ou onomatopeias deformadas têm estruturas de traço bem distantes das fontes impressas.
- Imagem instável: a tela está em movimento no momento do reconhecimento — animações de transição, legendas que surgem e somem com fade; o que se lê são letras semitransparentes ou incompletas.
- Layout interpretado errado: em mangá vertical ou páginas de várias colunas, se a ordem de leitura for calculada errada, a ordem das frases reconhecidas vira uma confusão.
- Resolução insuficiente: vídeos em baixa qualidade, capturas supercomprimidas ou desfoque causado pelo dimensionamento do sistema — se você mesmo não consegue ler as letras, a ferramenta também não vai conseguir.
O que fazer: quatro passos de investigação
Conhecendo a causa, a solução é corrigir apontando. Usando o VoriTrans como exemplo, a investigação pode seguir esta ordem:
Passo 1: reduza a área de seleção. Enquadre só o pedaço onde está o texto desejado, não a tela inteira — quanto menor o enquadramento, menos interferência e mais preciso o reconhecimento.
Passo 2: espere a imagem estabilizar antes de traduzir. Nas preferências existe a opção de “espera de estabilização de imagem”, ajustável em milissegundos; em conteúdos com legendas animadas ou muitos efeitos de transição, deixe a ferramenta esperar a imagem assentar antes de reconhecer.

Passo 3: troque o motor de OCR. As preferências oferecem 4 motores de OCR para escolher; teste outro motor na mesma imagem e o resultado pode mudar bastante — nenhum motor vence em todos os cenários, fixe o que for mais estável para o seu conteúdo.
Passo 4: nova tentativa pontual e correção de termos. Se algum trecho foi reconhecido mal, use a “tradução única” enquadrando só aquela área pequena e tente de novo; com palavras fixas que sempre saem erradas (nomes próprios, termos do sistema), use a correção de OCR do glossário de termos para fixar a grafia correta, e ela vale automaticamente na próxima tradução.
E quando a tradução não é boa: modelos, termos e expectativas certas
Se o texto original reconhecido está certo e o problema está na tradução, também há bastante o que ajustar. Para o modelo de tradução, comece pelo “modelo local”, que não consome créditos: a capacidade é limitada, mas serve para validar; em trechos importantes que exigem compreensão de contexto, troque para os modelos em nuvem (Qwen, DeepSeek, GLM) e compare a tradução da mesma frase — a diferença normalmente dá para ver de cara. As regras de consumo de créditos seguem a página de preços oficial.
O tom e os nomes ficam por conta de duas coisas: o “prompt de tradução de jogos” nas preferências permite personalizar o estilo da tradução para acompanhar o tom da obra, e o glossário de termos fixa nomes dos personagens e termos próprios do mundo numa mesma tradução, coerente do começo ao fim. As expectativas também precisam estar no lugar: o objetivo da tradução com IA é você acompanhar a história sem tropeços, não uma tradução de nível editorial — interpretar alguma frase isolada com o contexto e a imagem na mão faz parte do uso normal, não é falha da ferramenta. Para mais contexto sobre falhas de reconhecimento, veja o artigo anterior o que é um tradutor de tela.
Quando desconfiar que o problema é a própria imagem
No fim da investigação, existe um tipo de problema cuja raiz não está na ferramenta: vídeos em baixa qualidade, imagens com censura em mosaico, conteúdos protegidos e o modo exclusivo de tela cheia — a própria imagem não oferece texto reconhecível, e nenhuma ferramenta resolve isso. Quando o reconhecimento falhar em tela cheia, troque primeiro para modo em janela ou sem bordas e teste de novo; é a recomendação oficial mais comum. Ao contrário, para avaliar o nível real de uma ferramenta, teste-a com imagens nítidas e estáveis: o modelo local consome créditos gratuitos — 1.000 por mês para visitantes e 2.000 após o registro —; rode uma noite com o conteúdo que você costuma assistir, e isso vale mais do que qualquer resenha.
Perguntas frequentes
Qual é a precisão máxima da tradução com IA?
Não existe um número único, nem deveria existir — a precisão depende da nitidez do texto, do layout e das condições da imagem, e o mesmo conteúdo dá resultados diferentes conforme a forma de exibição. Uma ferramenta responsável não promete porcentagens; o que ela pode fazer é abrir o painel de “texto original reconhecido” para você mesmo conferir: se o reconhecimento está certo, aí sim olhe a tradução, e fica evidente em qual etapa está o problema.
E quando as mesmas palavras sempre saem erradas no reconhecimento?
Use a correção de OCR do glossário de termos: adicione a palavra original lida errada junto com a grafia correta; dá para marcar a opção de ignorar maiúsculas e minúsculas, e a alteração vale automaticamente na próxima tradução, sem corrigir na mão toda vez. O glossário aceita importação e exportação, então você pode levá-lo ao trocar de computador.
Trocar para um modelo em nuvem traduz melhor?
A compreensão de contexto e o tratamento de frases longas costumam ser melhores, ao custo de consumir créditos. A recomendação é comparar com a mesma fala: traduza uma vez com o modelo local e outra com o modelo em nuvem, e fique com o que se encaixar melhor no seu conteúdo — diálogos curtos de graça com o modelo local e trechos importantes na nuvem é o equilíbrio comum entre custo e qualidade.


