Ketepatan Terjemahan AI: Punca dan Cara Membaikinya
Alat penterjemah skrin yang sama, semalam berjalan baik, hari ini tiba-tiba penuh ralat; atau kawan guna sangat tepat, giliran sendiri sekali guna terus bercelaru — menghadapi keadaan begini, tindak balas pertama kebanyakan orang ialah "alat ini terjemahannya tidak tepat". Kesimpulan itu terlalu cepat. Terjemahan yang salah ada dua punca yang benar-benar berbeza: tulisan tidak dibaca dengan betul, atau dibaca betul tetapi diterjemahkan dengan lemah. Pisahkan dulu dua perkara ini, barulah isu ketepatan boleh dibincangkan.
Pisahkan dahulu: kegagalan pengecaman dan kegagalan terjemahan adalah dua perkara berbeza
Aliran kerja penterjemahan skrin terbahagi dua langkah: OCR menukarkan tulisan pada skrin menjadi teks yang boleh disunting terlebih dahulu, kemudian AI menterjemahkan teks itu ke bahasa sasaran pilihan anda. Mana-mana langkah yang tersilap, terjemahan yang anda lihat pasti tidak tepat, tetapi tanggungjawab dan penyelesaiannya benar-benar berbeza.
Cara membezakannya ada dalam apl: di sebelah hasil terjemahan terdapat panel "Teks sumber pengecaman" yang memaparkan apa yang sebenarnya dibaca oleh OCR kali ini. Jika dalam panel pengecaman itu sendiri sudah penuh kesilapan, itu masalah pengecaman — pergi betulkan kotak pilihan dan keadaan skrin; jika teks sumber betul tetapi terjemahan salah, barulah itu masalah terjemahan — pergi laraskan model dan istilah. Lihat dahulu langkah ini sebelum bertindak, arah penyiasatan tidak akan terpesong.
Kegagalan pengecaman OCR, punca biasanya cuma enam ini
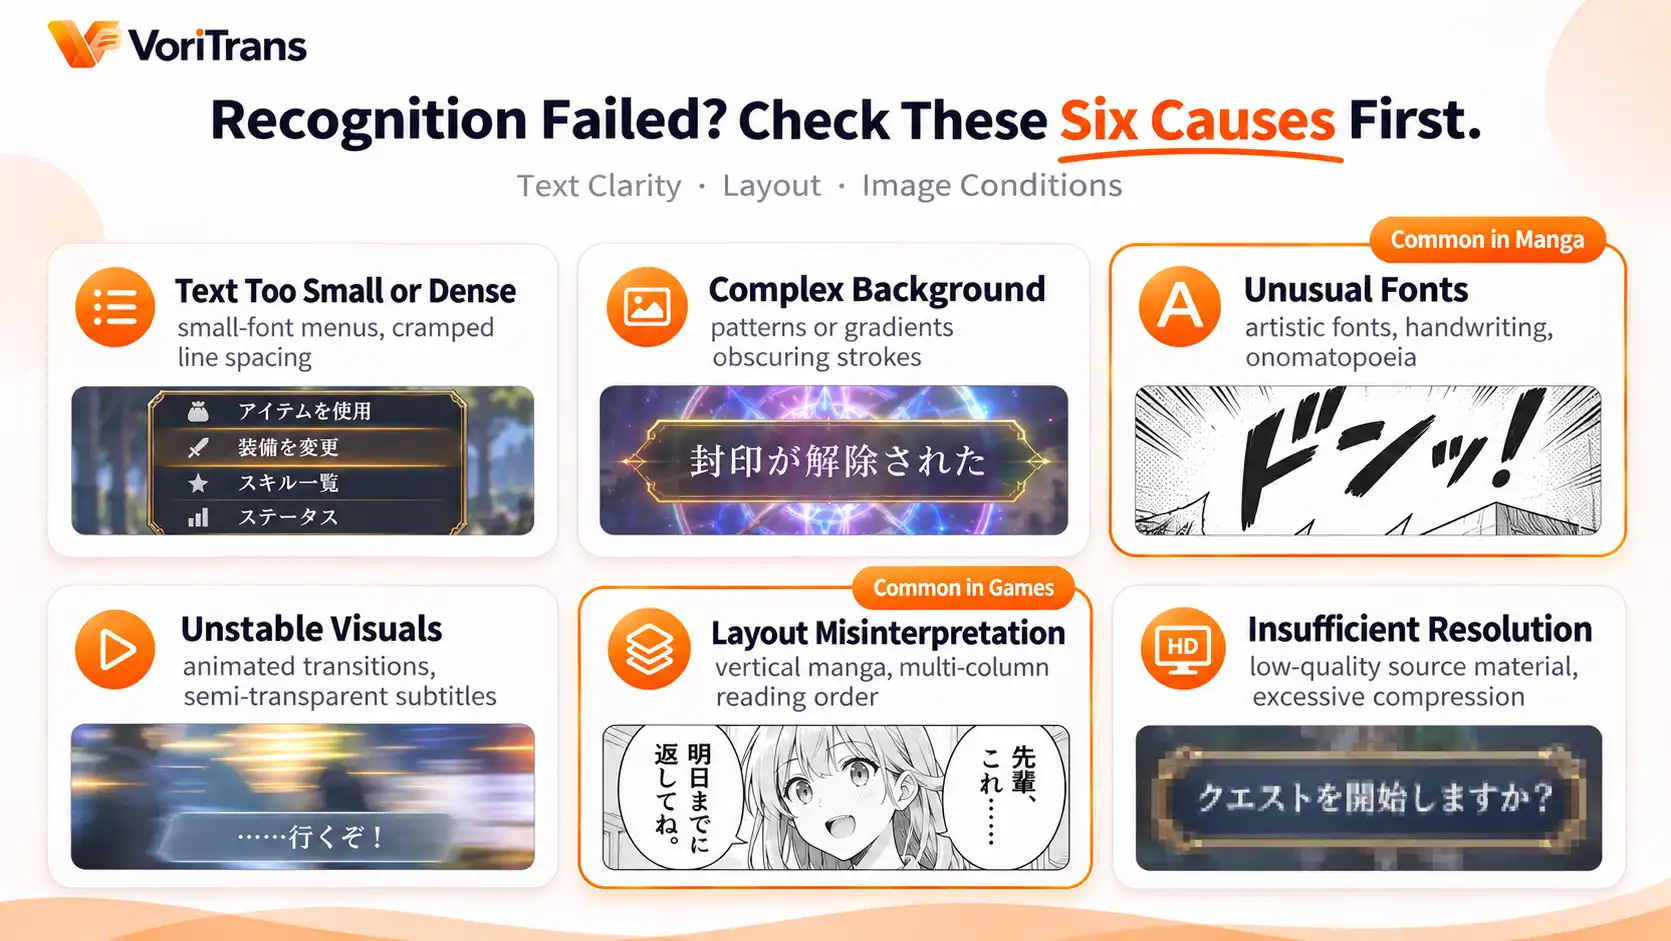
Kualiti pengecaman bergantung pada kejelasan tulisan, susun atur dan keadaan skrin — dengan garis ukur ini, hampir semua senario kegagalan boleh dimasukkan ke dalam enam kategori berikut:
- Tulisan terlalu kecil atau terlalu padat: huruf kecil pada antara muka permainan, senarai menu jarak baris rapat, aksara melekat antara satu sama lain, OCR tidak dapat membezakan sempadannya.
- Latar belakang rumit: tulisan bertindih pada corak, gradien, kesan cahaya, goresan aksara bercampur dengan latar.
- Fon istimewa: huruf artistik, tulisan tangan, kata onomatope yang terherot, struktur goresannya jauh berbeza daripada huruf cetak.
- Skrin tidak stabil: pada detik pengecaman gambar sedang bergerak — animasi peralihan, sari kata yang muncul dan pudar, yang terbaca ialah aksara separa lut sinar atau tidak lengkap.
- Salah menilai susun atur: komik menegak, susun atur berbilang lajur, sekali urutan bacaan dinilai salah, urutan ayat hasil pengecaman terus bercelaru.
- Resolusi tidak mencukupi: sumber video jernih rendah, tangkapan skrin dimampatkan terlalu kuat, kabur disebabkan penskalaan sistem — mata manusia sahaja sudah sukar melihat tulisannya, alat semestinya juga tidak dapat membacanya dengan jelas.
Kaedah pembaikan yang sepadan, empat langkah
Setelah tahu punca, caranya ialah membetulkan terus. Mengambil VoriTrans sebagai contoh, pembaikan boleh dibuat mengikut urutan berikut:
Langkah 1: Kecilkan kotak pemilihan. Pilih hanya bahagian tulisan sasaran, jangan masukkan keseluruhan skrin — semakin kecil pilihan, semakin sedikit gangguan, pengecaman semakin tepat.
Langkah 2: Tunggu skrin stabil dahulu sebelum menterjemah. Dalam tetapan ada "masa tunggu kestabilan skrin" boleh dilaras mengikut milisaat; untuk kandungan dengan sari kata bergerak dan kesan peralihan yang banyak, biarkan alat menunggu gambar tenang dahulu sebelum mengecam.

Langkah 3: Tukar enjin OCR lain. Tetapan menyediakan 4 enjin OCR untuk dipilih, gambar yang sama dicuba dengan enjin berbeza, hasilnya mungkin jelas berbeza — tiada enjin yang terkehol di semua situasi, kandungan anda paling stabil dengan yang mana, kekalkan pilihan itu.
Langkah 4: Cuba semula sekali gus ditambah pembetulan istilah. Bahagian yang dikenali dengan kurang baik, gunakan "Terjemah Sekali" dengan kotak kecil untuk mencuba semula; perkataan tetap yang selalu salah dibaca (nama orang, perkataan sistem), dalam "Bank Istilah" gunakan fungsi pembetulan OCR untuk mengunci perkataan asal kepada ejaan yang betul, terjemahan seterusnya automatik terpakai.
Bagaimana jika terjemahan tidak tepat: model, istilah dan jangkaan yang betul
Jika teks sumber pengecaman betul, masalahnya berada di peringkat penterjemahan, bahagian yang boleh dilaras juga tidak sedikit. Untuk model terjemahan, mula dengan "model setempat" dahulu — tidak menggunakan kredit, keupayaannya terhad tetapi sesuai untuk pengesahan; bab penting yang menuntut kefahaman konteks tinggi, beralih ke model awan (Qwen, DeepSeek, GLM) untuk membandingkan terjemahan ayat yang sama, perbezaannya biasanya dapat dilihat terus, peraturan penggunaan kredit merujuk pada halaman harga rasmi.
Isu nada dan nama khas diserahkan pada dua perkara: "arahan terjemahan permainan" dalam tetapan boleh menyesuaikan gaya terjemahan supaya hasilnya selari dengan nada karya; bank istilah mengunci nama watak utama dan istilah khusus cerita menjadi satu terjemahan yang seragam sepanjang karya. Jangkaan juga perlu betul: matlamat terjemahan AI ialah membolehkan anda mengikuti jalan cerita dengan lancar, bukan terjemahan peringkat penerbitan — sesetengah ayat perlu difahami bersama konteks dan imej, itu cara penggunaan biasa, bukan alat yang rosak. Untuk latar belakang lanjut tentang pengecaman yang tidak tepat, boleh rujuk artikel sebelum ini Apa Itu Penterjemah Skrin.
Bilakah patut syak pada imej itu sendiri
Setelah disiasat hingga ke hujung, ada satu golongan masalah yang punyanya bukan pada alat: sumber video jernih rendah, imej yang ditutup dengan mozek, kandungan tersulit, mod skrin penuh eksklusif — imej itu sendiri sudah tidak menyediakan tulisan yang boleh dikenali, tukar alat mana pun hasilnya sama. Apabila pengecaman dalam mod skrin penuh tidak normal, tukar dahulu ke mod tetingkap atau tanpa bingkai kemudian cuba semula, ini nasihat utama daripada pihak rasmi. Sebaliknya, untuk menguji tahap sebenar sesebuah alat juga perlu menggunakan imej yang jelas dan stabil: model setempat menggunakan kredit percuma, pelawat 1,000 sebulan, selepas mendaftar 2,000, cuba semalaman dengan kandungan yang biasa anda tonton, lebih dipercayai daripada sebarang ulasan.
Soalan Lazim
Sejauh mana ketepatan terjemahan AI boleh mencapai?
Tiada angka seragam, dan sepatutnya tidak ada — ketepatan bergantung pada kejelasan tulisan, susun atur dan keadaan skrin, kandungan yang sama dengan cara paparan berbeza hasilnya pun berbeza. Alat yang bertanggungjawab tidak akan menjanjikan peratusan; yang boleh dilakukan ialah membuka panel "Teks sumber pengecaman" untuk anda sendiri menyemak, pengecaman betul barulah lihat terjemahan, masalah berada di peringkat mana jelas terus.
Sentiasa salah mengecam kumpulan perkataan yang sama, bagaimana?
Guna pembetulan OCR dalam bank istilah: tambahkan perkataan asal yang salah dibaca dan ejaan yang betul, boleh tanda untuk abaikan huruf besar/kecil Inggeris, selepas diubah terjemahan seterusnya automatik terpakai, tidak perlu ubah manual setiap kali. Bank istilah ini menyokong import/eksport, tukar peranti pun boleh dibawa bersama.
Tukar ke model awan akan lebih tepat?
Biasanya lebih baik dalam kefahaman konteks dan pengendalian ayat panjang, kosnya ialah penggunaan kredit. Disarankan bandingkan dengan dialog yang sama: terjemah sekali dengan model setempat, sekali dengan model awan, perbezaan yang mana sesuai dengan kandungan anda itulah digunakan — dialog pendek guna model setempat percuma, bab penting beralih ke awan, itu cara keseimbangan lazim antara kos dan kualiti.