
Akurasi Terjemahan AI: Penyebab dan Cara Memperbaikinya
Alat penerjemah layar yang sama, kemarin terjemahannya bagus, hari ini tiba-tiba penuh kesalahan; atau teman pakainya akurat, begitu giliran sendiri malah berantakan — menghadapi situasi seperti ini, reaksi pertama kebanyakan orang adalah "alat ini terjemahannya tidak akurat". Kesimpulan itu terlalu cepat. Hasil terjemahan yang salah punya dua sumber yang sama sekali berbeda: teks tidak terbaca dengan benar, atau terbaca benar tetapi diterjemahkan dengan buruk. Pisahkan dulu dua hal ini, barulah masalah akurasi bisa dibahas.
Pisahkan dulu: kegagalan pengenalan dan kegagalan terjemahan adalah dua hal berbeda
Alur kerja penerjemahan layar terdiri dari dua tahap: OCR mengubah teks di layar menjadi teks yang bisa diedit terlebih dahulu, lalu AI menerjemahkan teks itu ke bahasa tujuan pilihan Anda. Tahap mana pun yang salah, hasil terjemahan yang Anda lihat pasti keliru, tetapi tanggung jawab dan solusinya sama sekali berbeda.
Cara membedakannya ada di dalam aplikasi: di samping hasil terjemahan ada panel "Teks sumber hasil pengenalan" yang menampilkan apa yang benar-benar dibaca OCR kali ini. Kalau di panel pengenalan itu sendiri sudah penuh kesalahan, itu masalah pengenalan — perbaiki area seleksi dan kondisi layar; kalau teks sumber benar tetapi terjemahan salah, barulah itu masalah terjemahan — atur model dan glosarium. Periksa dulu satu langkah ini sebelum bertindak, arah pencarian masalah tidak akan meleset.
Gagal pengenalan OCR, penyebab umumnya hanya enam ini
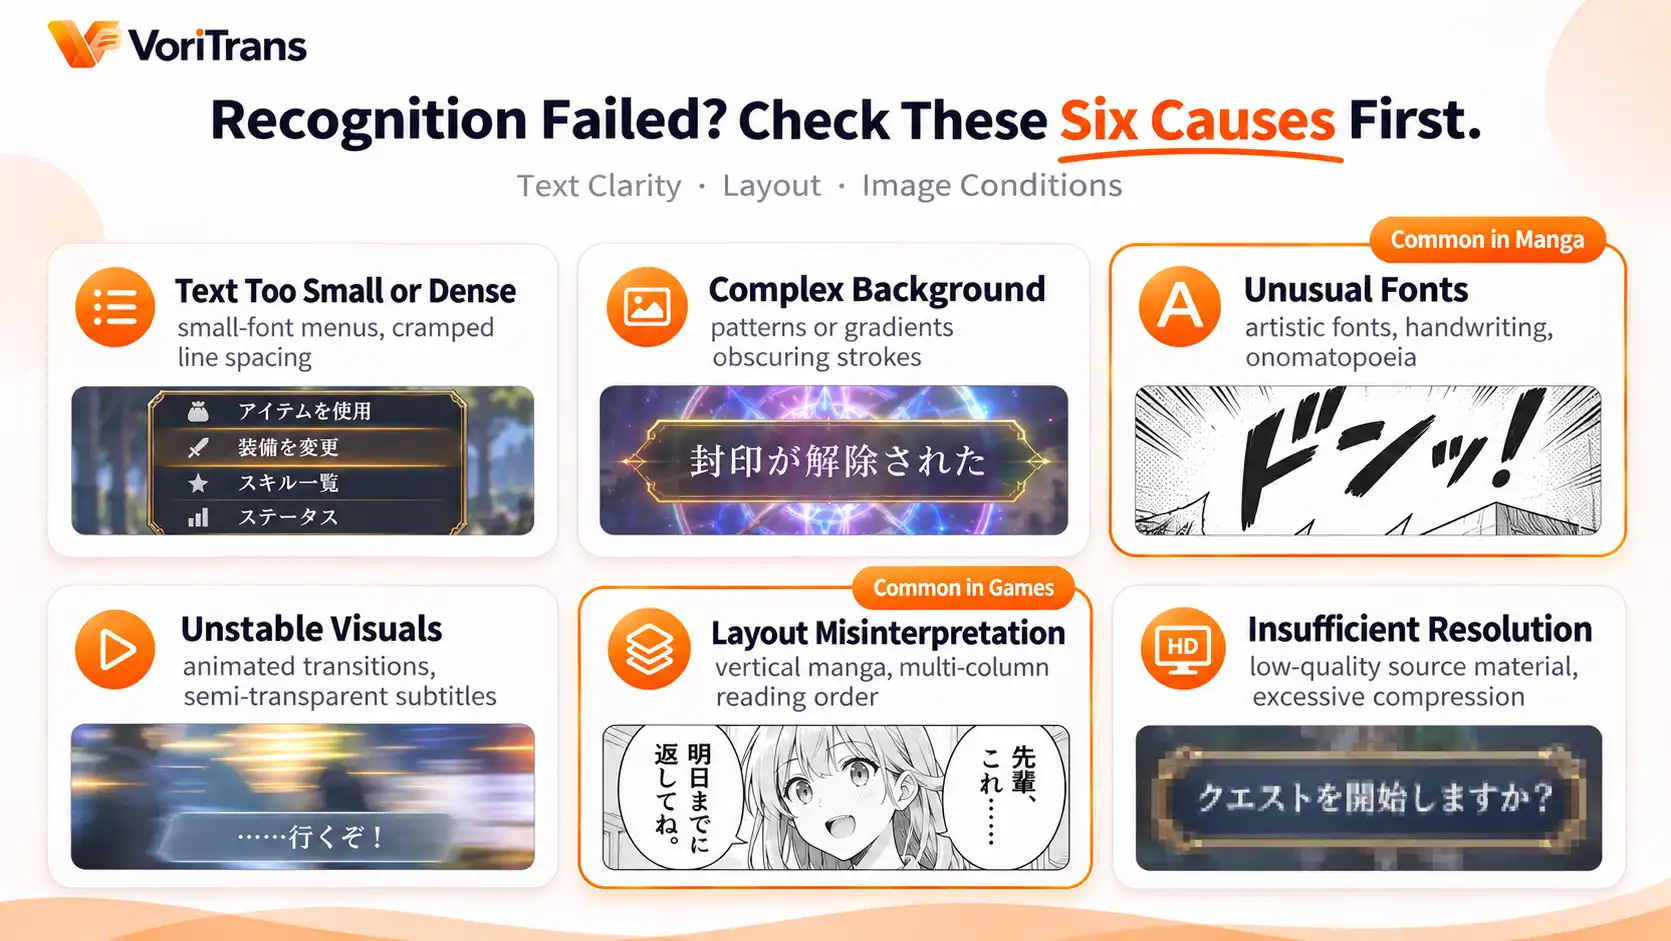
Hasil pengenalan ditentukan oleh kejelasan teks, tata letak, dan kondisi layar — dengan ukuran ini, hampir semua skenario kegagalan masuk ke enam kategori berikut:
- Teks terlalu kecil atau terlalu rapat: huruf kecil di layar game, daftar menu dengan spasi baris sempit, karakter menempel satu sama lain, OCR tidak bisa membedakan batasnya.
- Latar belakang rumit: teks bertumpuk pada pola, gradasi, efek cahaya, goresan huruf bercampur dengan latar.
- Font khusus: huruf artistik, tulisan tangan, kata onomatope yang terdistorsi, struktur goresannya jauh dari huruf cetak.
- Layar tidak stabil: tepat saat pengenalan, gambar sedang bergerak — animasi transisi, subtitel yang memudar atau muncul, yang terbaca adalah huruf semi transparan atau tidak lengkap.
- Kesalahan penilaian tata letak: manga vertikal, tata letak multi kolom, begitu urutan baca dinilai salah, urutan kalimat hasil pengenalan ikut kacau.
- Resolusi tidak cukup: sumber video resolusi rendah, tangkapan layar terlalu terkompresi, blur akibat penskalaan sistem — mata manusia saja susah membaca teksnya, alat pasti juga susah membacanya.
Langkah pemeriksaannya, empat langkah
Setelah tahu penyebabnya, solusinya adalah memperbaikinya langsung. Mengambil VoriTrans sebagai contoh, pemeriksaan bisa dilakukan dalam urutan berikut:
Langkah 1: Persempit area seleksi. Seleksi hanya bagian teks target, jangan masukkan seluruh layar — semakin kecil area seleksi, semakin sedikit gangguan, pengenalan semakin akurat.
Langkah 2: Tunggu layar stabil dulu sebelum menerjemahkan. Di pengaturan ada "waktu tunggu stabilitas layar" yang bisa diatur dalam milidetik; untuk konten dengan subtitel bergerak dan efek transisi yang banyak, biarkan alat menunggu gambar tenang dulu sebelum mengenali.

Langkah 3: Ganti engine OCR lain. Pengaturan menyediakan 4 engine OCR pilihan, gambar yang sama dicoba dengan engine berbeda, hasilnya bisa jauh berbeda — tidak ada engine yang unggul di semua situasi, konten Anda paling stabil dengan yang mana, tetapkan pilihan itu.
Langkah 4: Coba ulang sekali pakai plus koreksi istilah. Untuk bagian yang dikenali buruk, gunakan "Terjemahkan Sekali" dengan seleksi kecil untuk mencoba lagi; kata tetap yang selalu salah dibaca (nama orang, kata sistem), di "Glosarium" gunakan fungsi koreksi OCR untuk mengunci kata asal ke ejaan yang benar, terjemahan berikutnya otomatis berlaku.
Kalau terjemahannya kurang akurat: model, istilah, dan ekspektasi yang tepat
Kalau teks sumber hasil pengenalan sudah benar, masalah ada di tahap penerjemahan, bagian yang bisa disetel juga tidak sedikit. Untuk model terjemahan, mulailah dengan "model lokal" dulu — tidak memakai kredit, kemampuannya terbatas tetapi cocok untuk verifikasi; bab penting yang menuntut pemahaman konteks tinggi, beralihlah ke model cloud (Qwen, DeepSeek, GLM) untuk membandingkan terjemahan kalimat yang sama, perbedaannya biasanya langsung terlihat, aturan pemakaian kredit mengacu pada halaman harga resmi.
Masalah nada dan nama khusus diserahkan pada dua hal: "prompt terjemahan game" di pengaturan bisa mengubah gaya terjemahan agar hasilnya sesuai nada karya; glosarium mengunci nama tokoh utama dan istilah khusus cerita menjadi satu terjemahan yang konsisten di seluruh karya. Ekspektasi juga harus pas: tujuan terjemahan AI adalah membuat Anda mengikuti alur cerita dengan lancar, bukan terjemahan setara penerbitan — beberapa kalimat perlu dipahami dengan konteks dan gambar, itu cara pakai yang normal, bukan alat yang rusak. Untuk latar belakang lebih lanjut soal pengenalan yang tidak akurat, baca artikel sebelumnya Apa Itu Penerjemah Layar.
Kapan sebaiknya curiga pada gambar itu sendiri
Setelah semua diperiksa, ada satu kelompok masalah yang akarnya bukan di alat: sumber video resolusi rendah, gambar yang disensor, konten terenkripsi, mode layar penuh eksklusif — gambarnya sendiri sudah tidak menyediakan teks yang bisa dikenali, alat apa pun hasilnya sama. Kalau pengenalan di mode layar penuh bermasalah, coba dulu pindah ke mode jendela atau tanpa border sebelum mencoba lagi, ini saran umum dari pihak resmi. Sebaliknya, untuk menguji kemampuan sebenarnya sebuah alat pun harus pakai gambar yang jelas dan stabil: model lokal memakai kredit gratis, pengunjung dapat 1.000 per bulan, setelah mendaftar 2.000, coba selama semalam dengan konten yang biasa Anda tonton, lebih bisa dipercaya daripada ulasan mana pun.
Pertanyaan Umum
Seberapa akurat terjemahan AI bisa mencapai?
Tidak ada angka tunggal, dan memang tidak seharusnya ada — akurasi bergantung pada kejelasan teks, tata letak, dan kondisi layar, konten yang sama dengan cara tampil berbeda hasilnya pun berbeda. Alat yang bertanggung jawab tidak menjanjikan persentase; yang bisa dilakukan adalah membuka panel "Teks sumber hasil pengenalan" agar Anda bisa memeriksa sendiri, setelah pengenalan benar baru lihat terjemahannya, masalah ada di tahap mana langsung ketahuan.
Kalau selalu salah mengenali kata yang sama, bagaimana?
Gunakan koreksi OCR di glosarium: tambahkan kata asal yang salah dibaca dan ejaan yang benar, bisa centang untuk mengabaikan huruf besar/kecil bahasa Inggris, setelah diubah terjemahan berikutnya otomatis berlaku, tidak perlu mengubah manual setiap kali. Glosarium ini mendukung impor/ekspor, ganti perangkat pun bisa dibawa.
Beralih ke model cloud akan lebih akurat?
Biasanya lebih baik dalam pemahaman konteks dan penanganan kalimat panjang, konsekuensinya memakai kredit. Sarannya bandingkan dengan dialog yang sama: terjemahkan sekali dengan model lokal, sekali dengan model cloud, yang perbedaannya cocok untuk konten Anda itulah yang dipakai — dialog pendek pakai model lokal gratis, bab penting beralih ke cloud, itu cara keseimbangan umum antara biaya dan kualitas.


